Rare-Event Modeling
MCMCベイズロジスティック回帰モデルによる慢性腎疾患(CKD)患者の透析移行リスクの予測
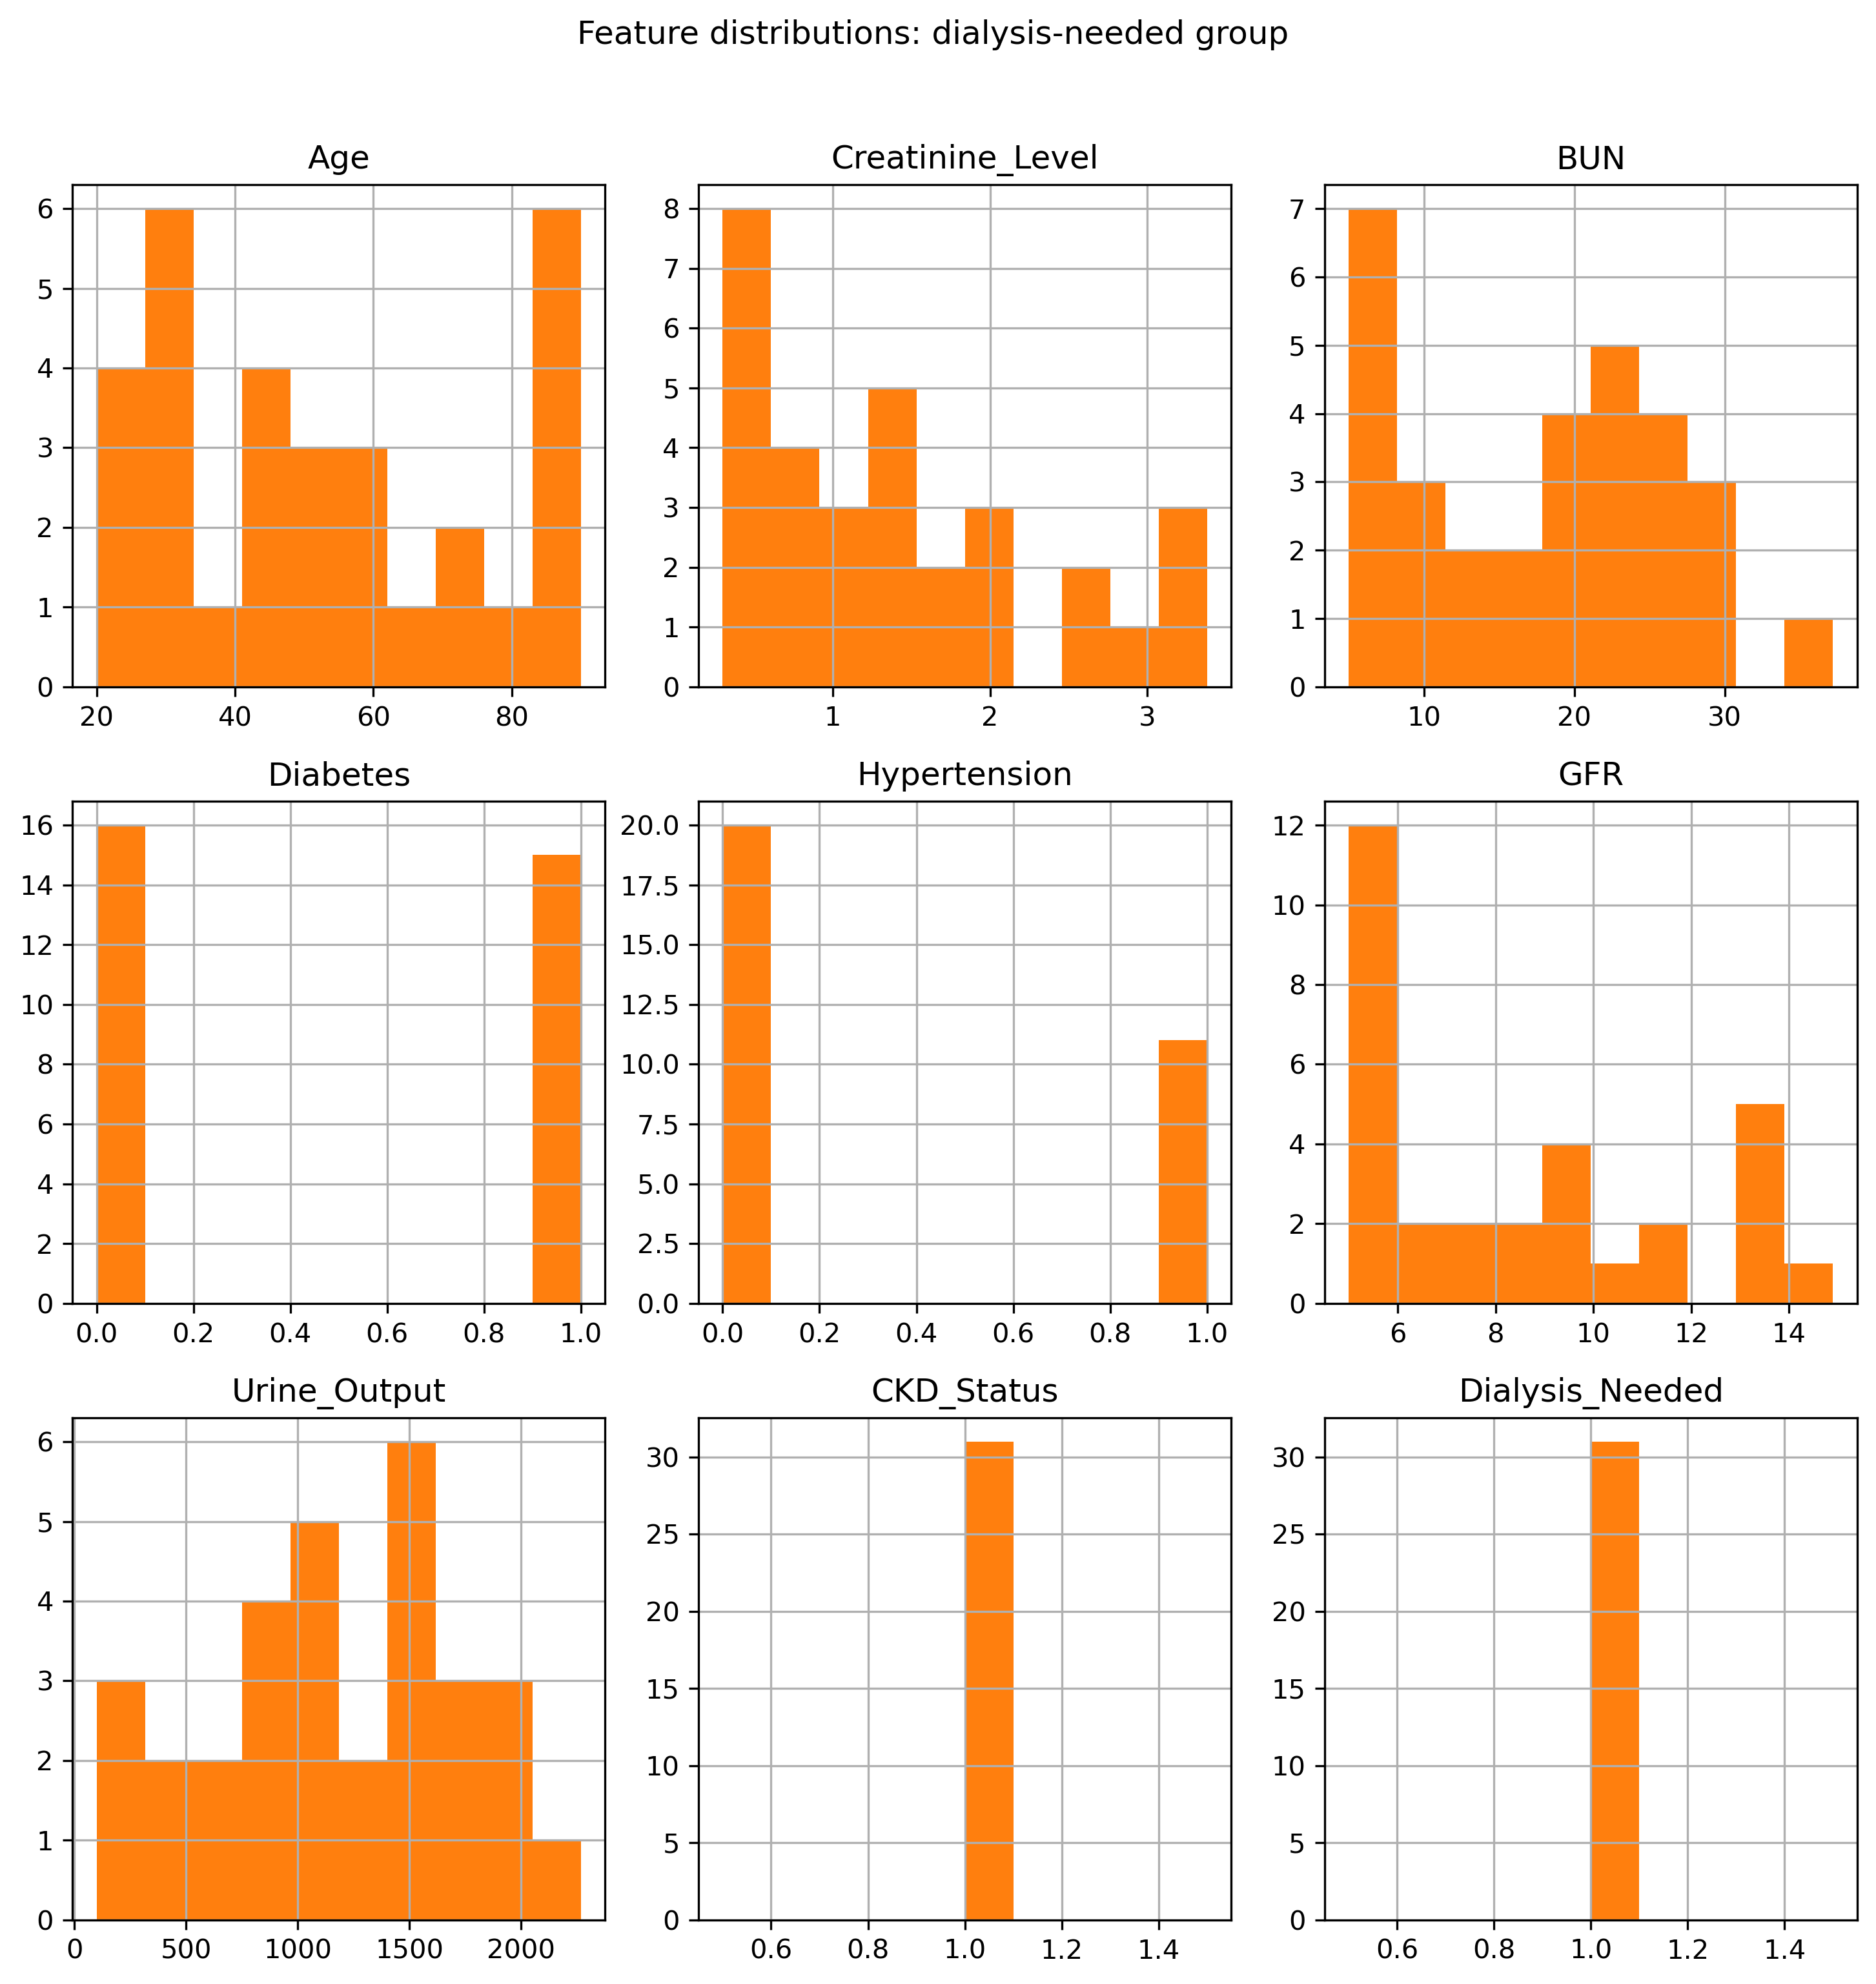
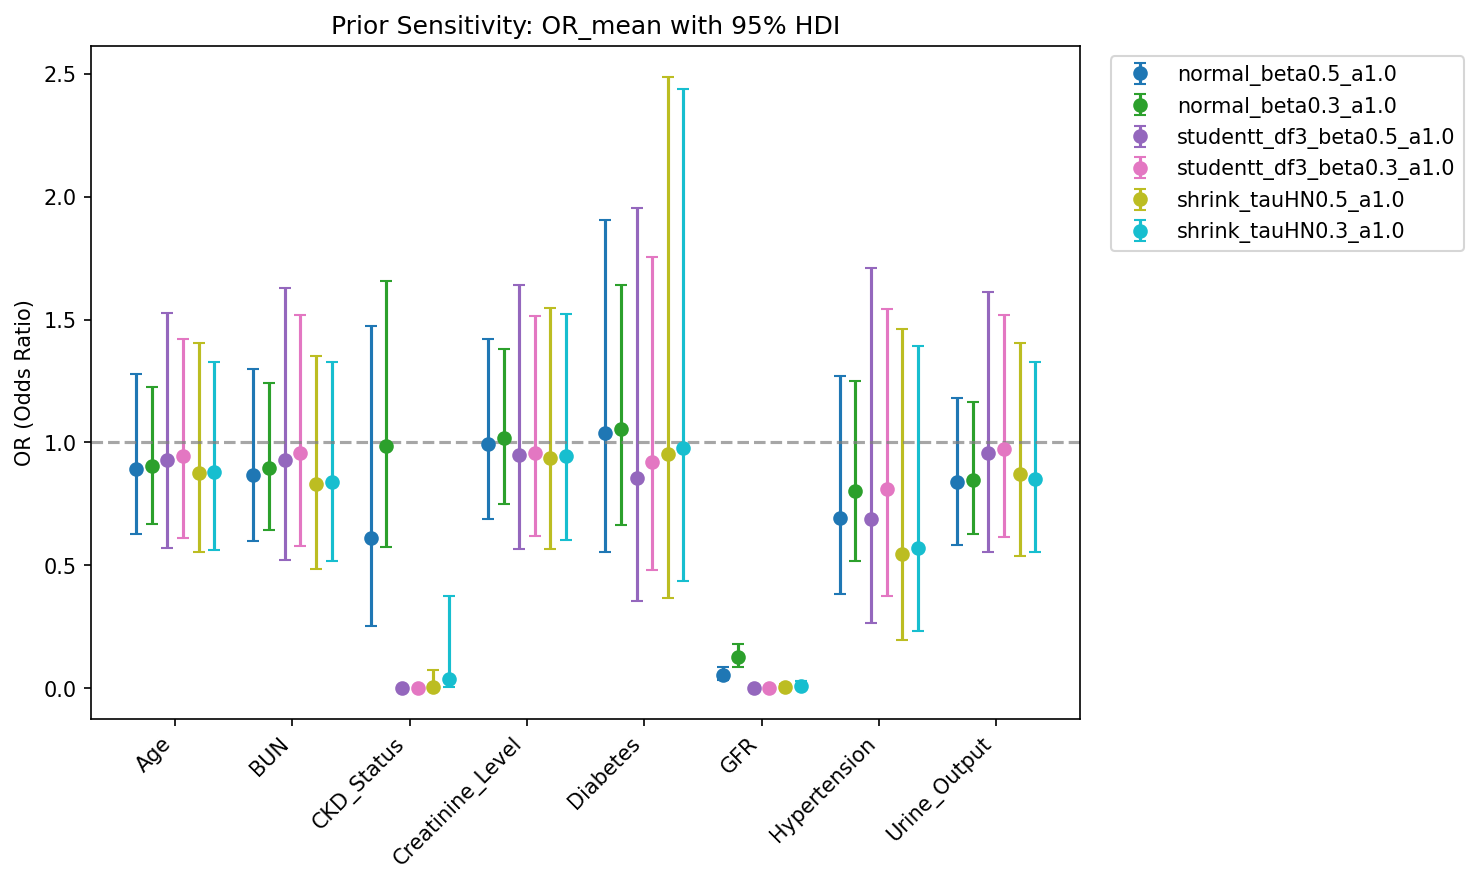
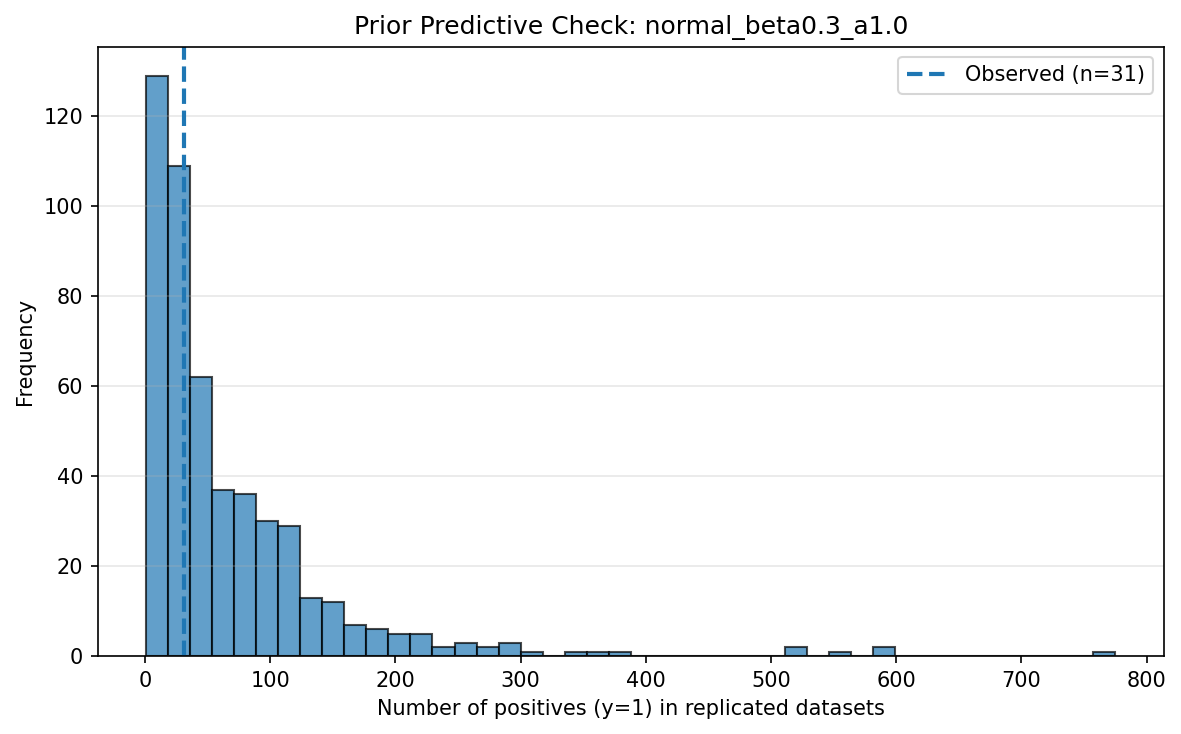
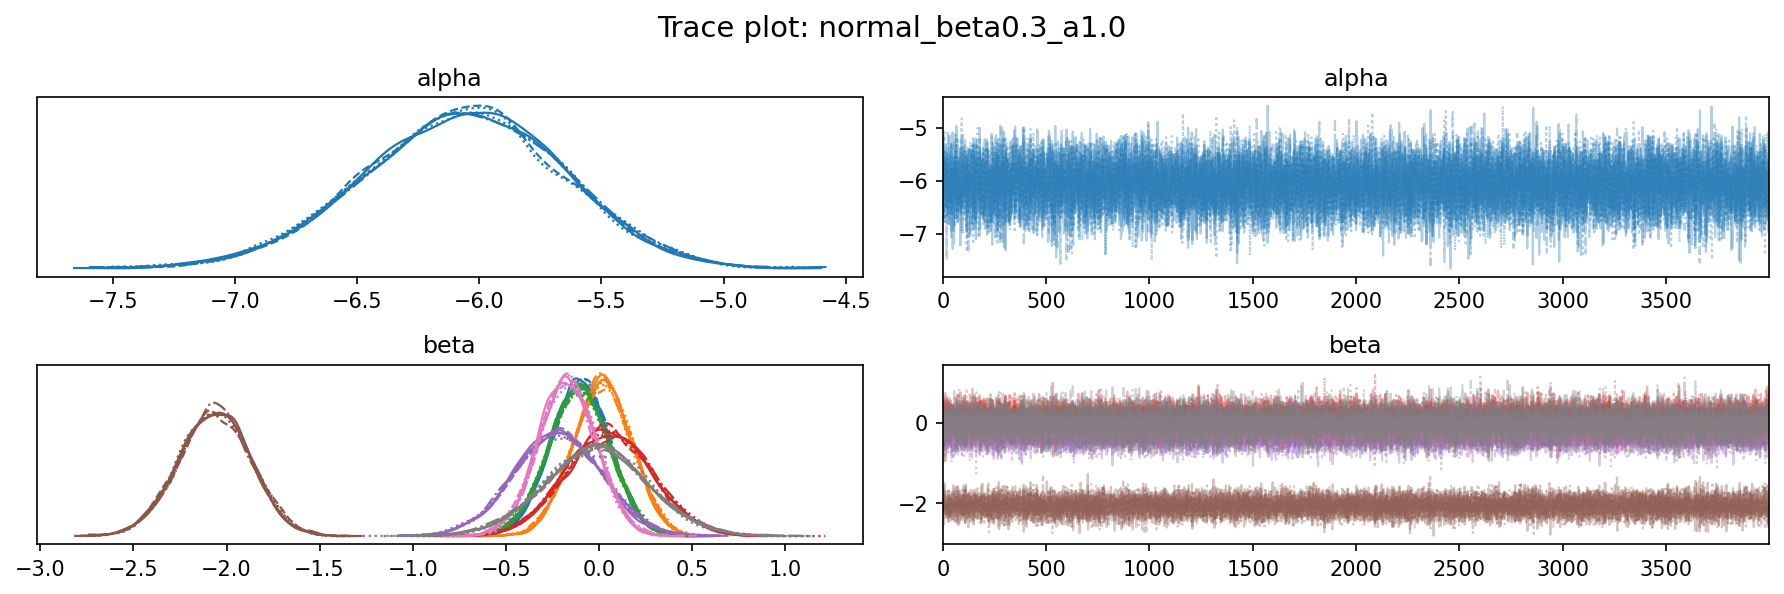
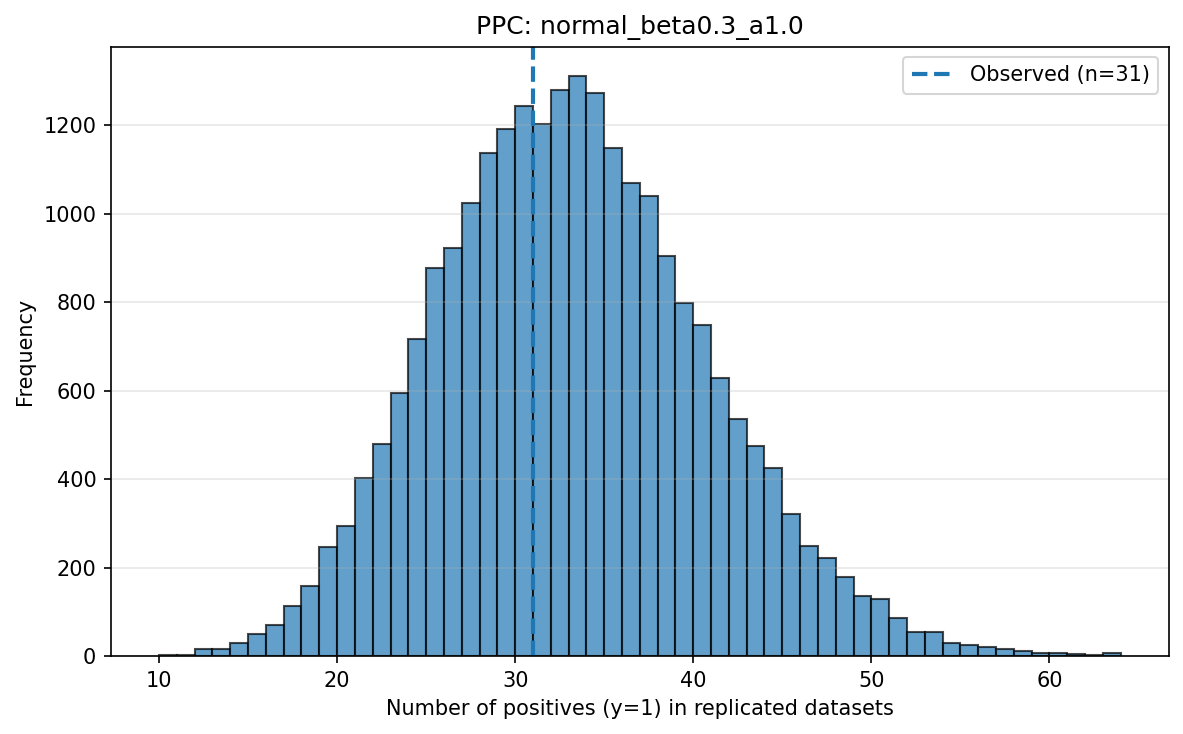
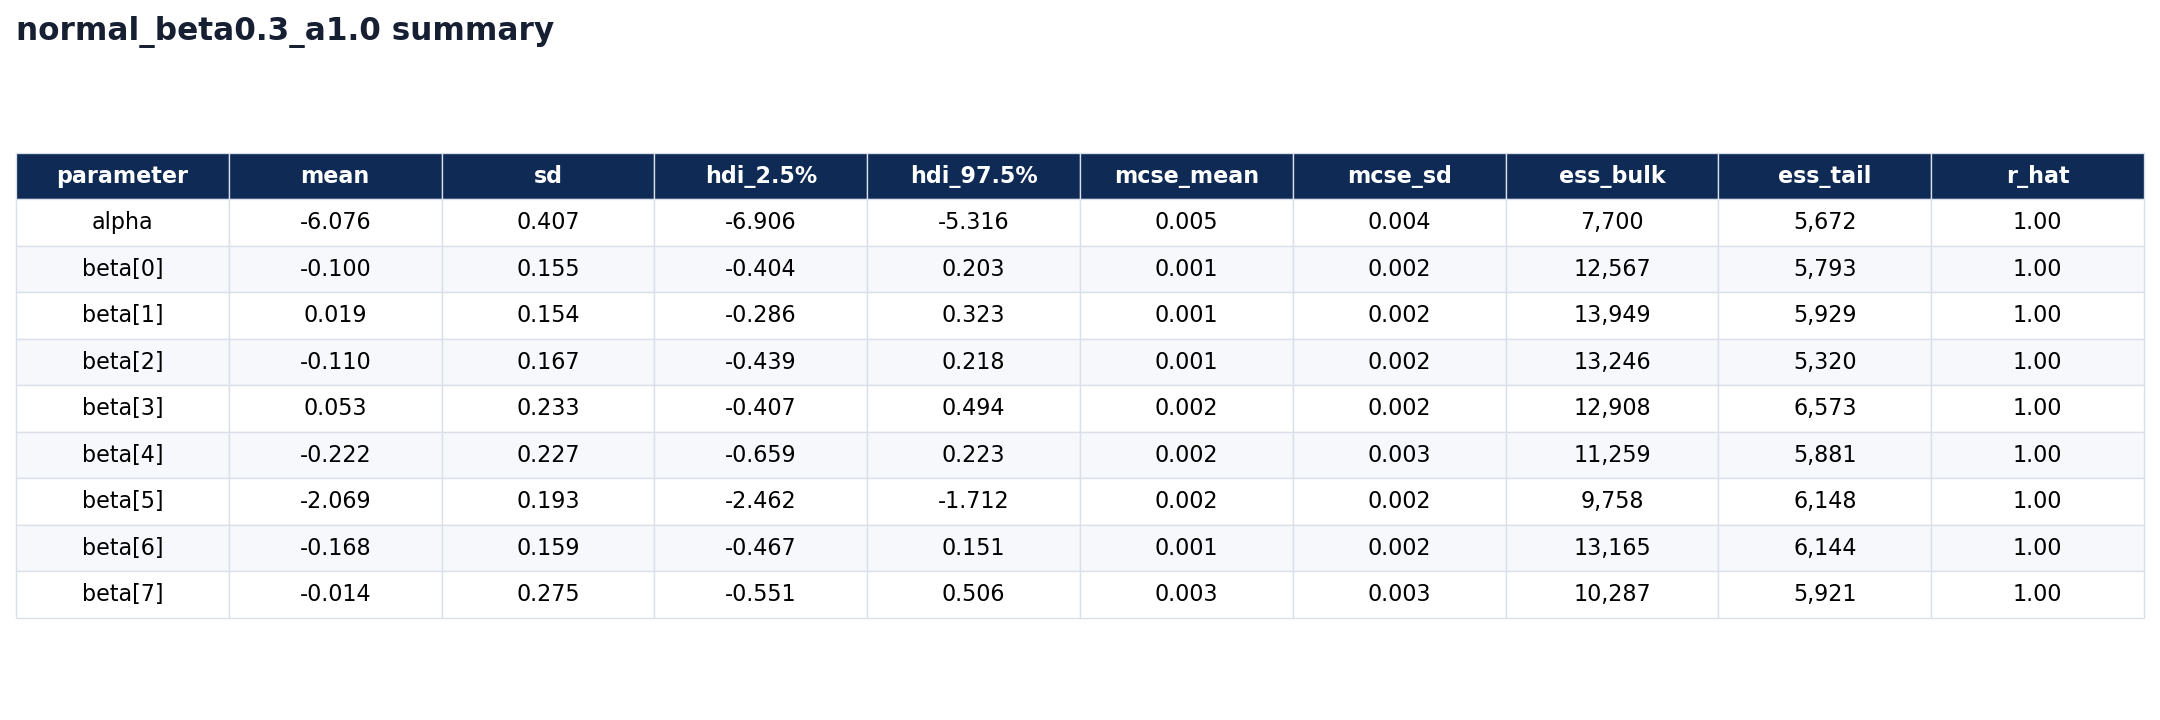
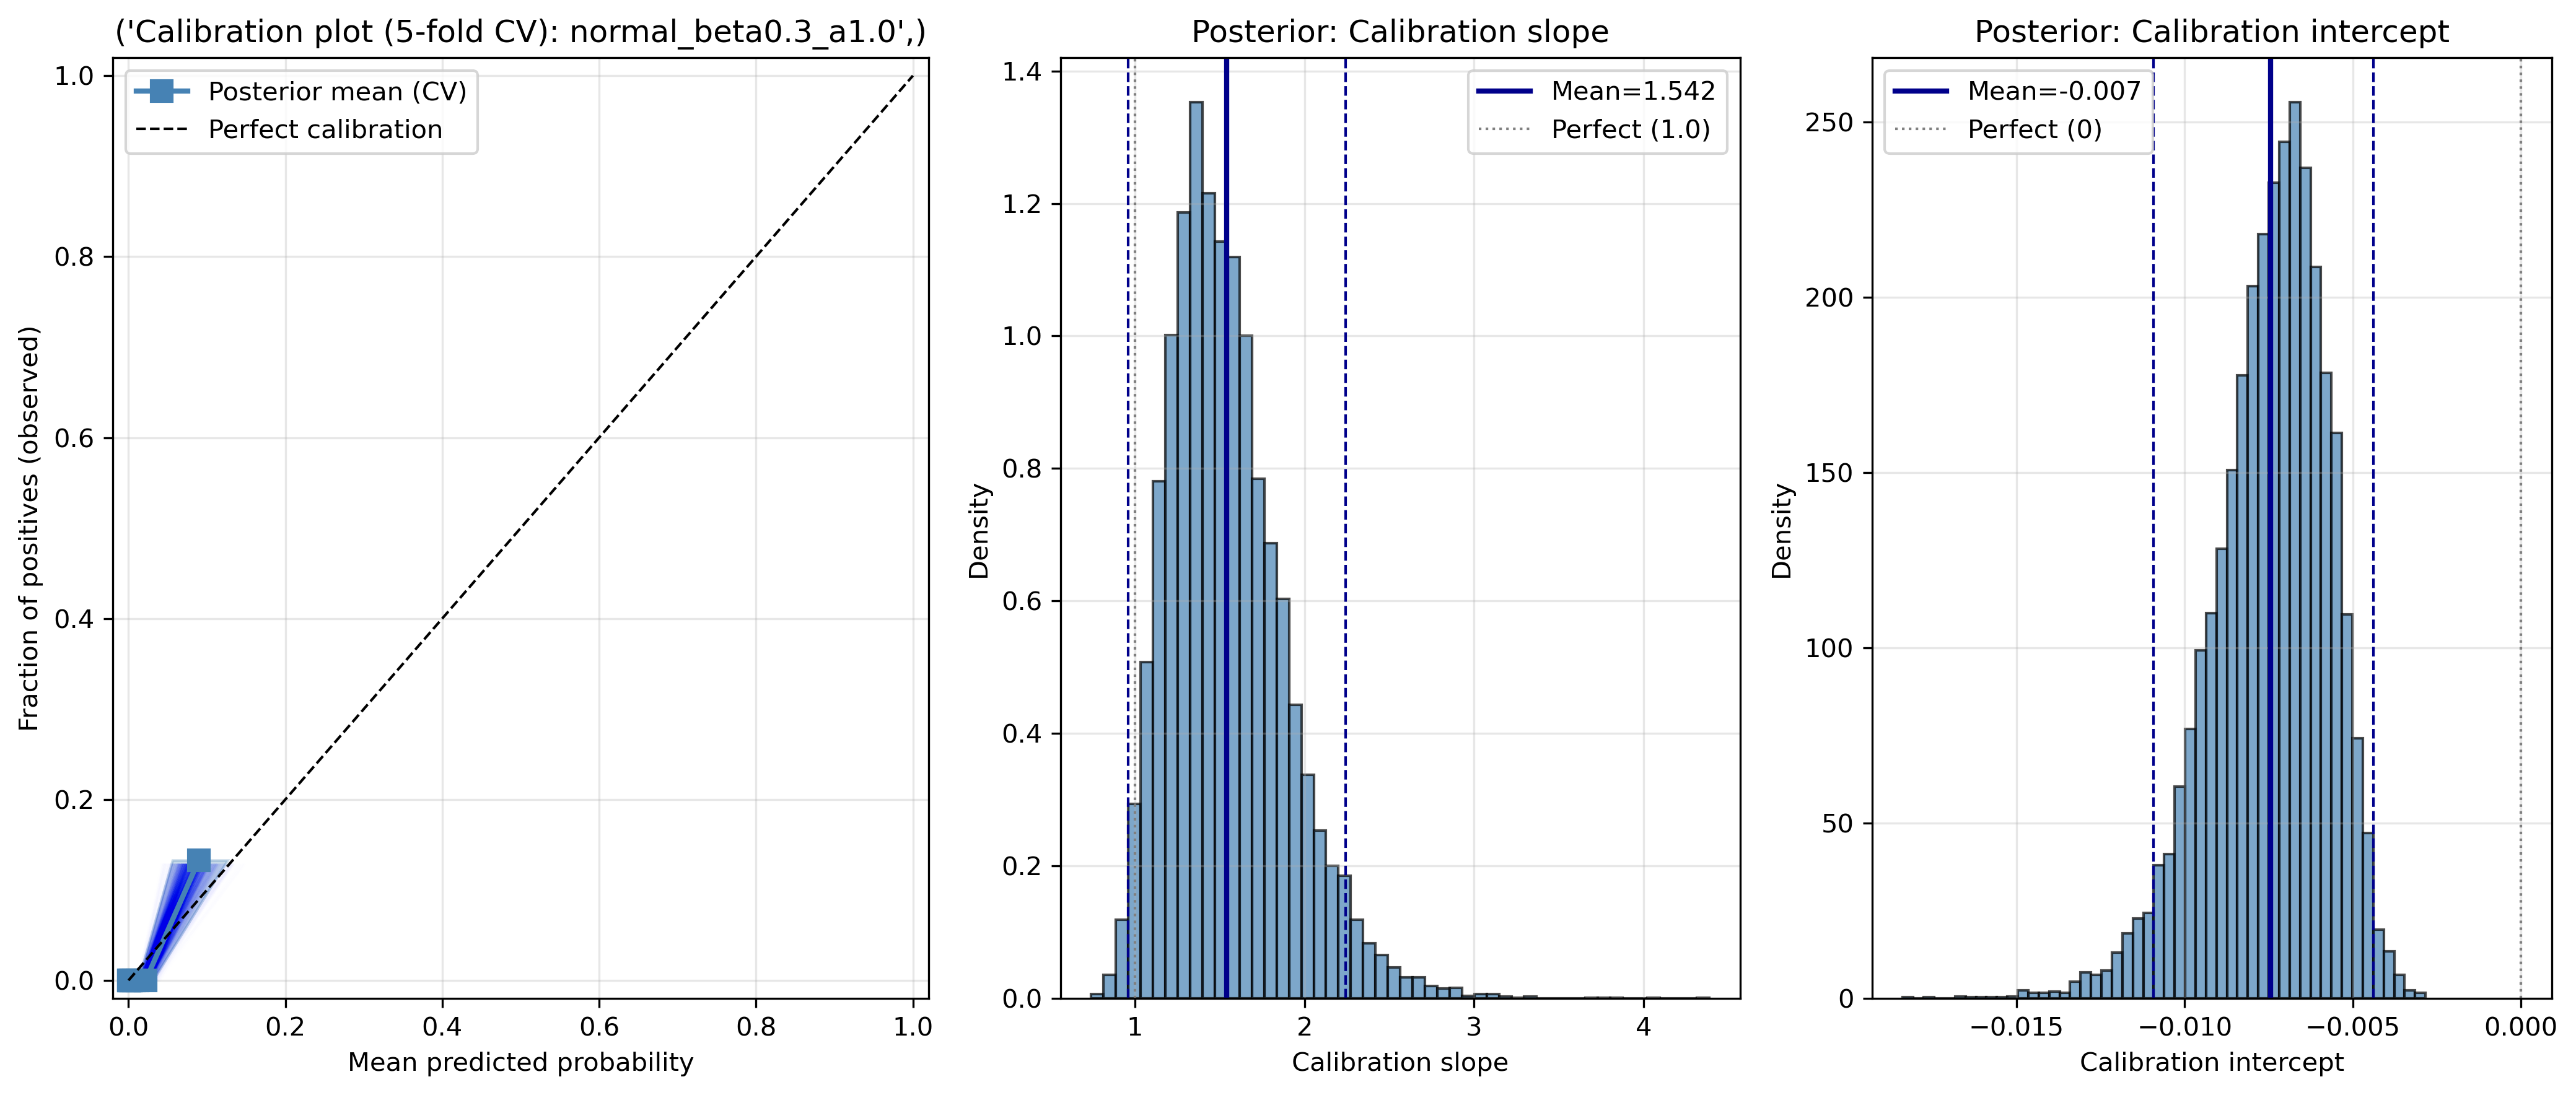
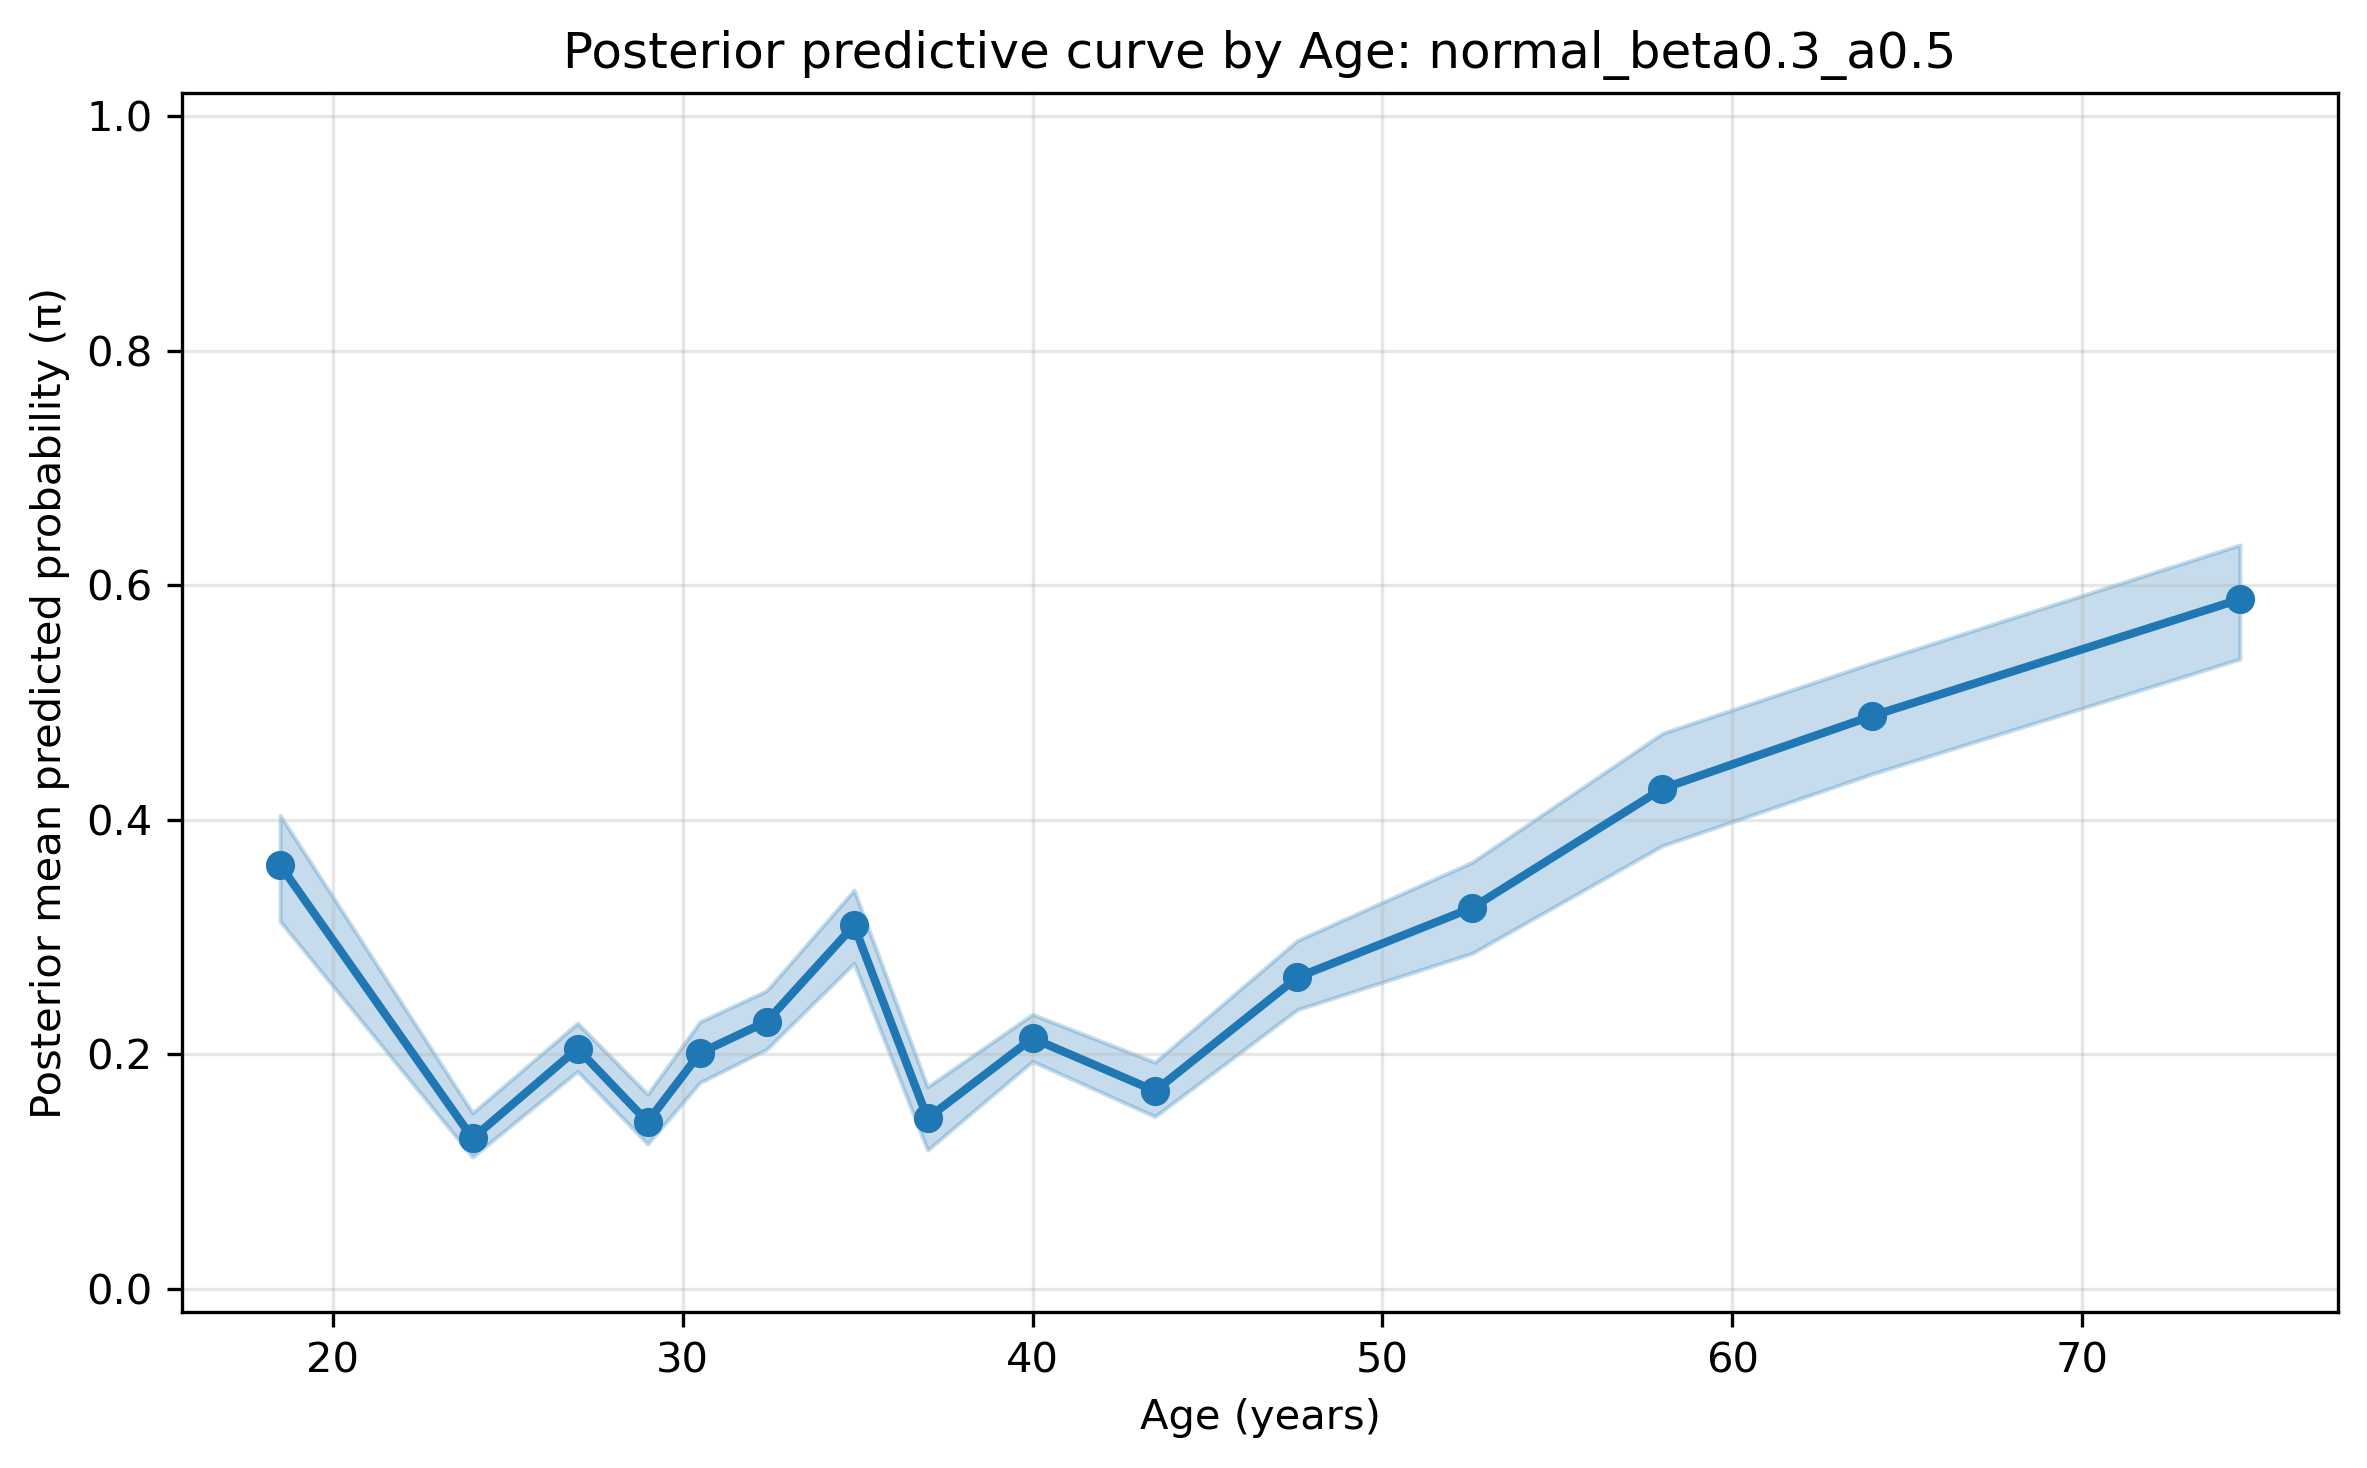
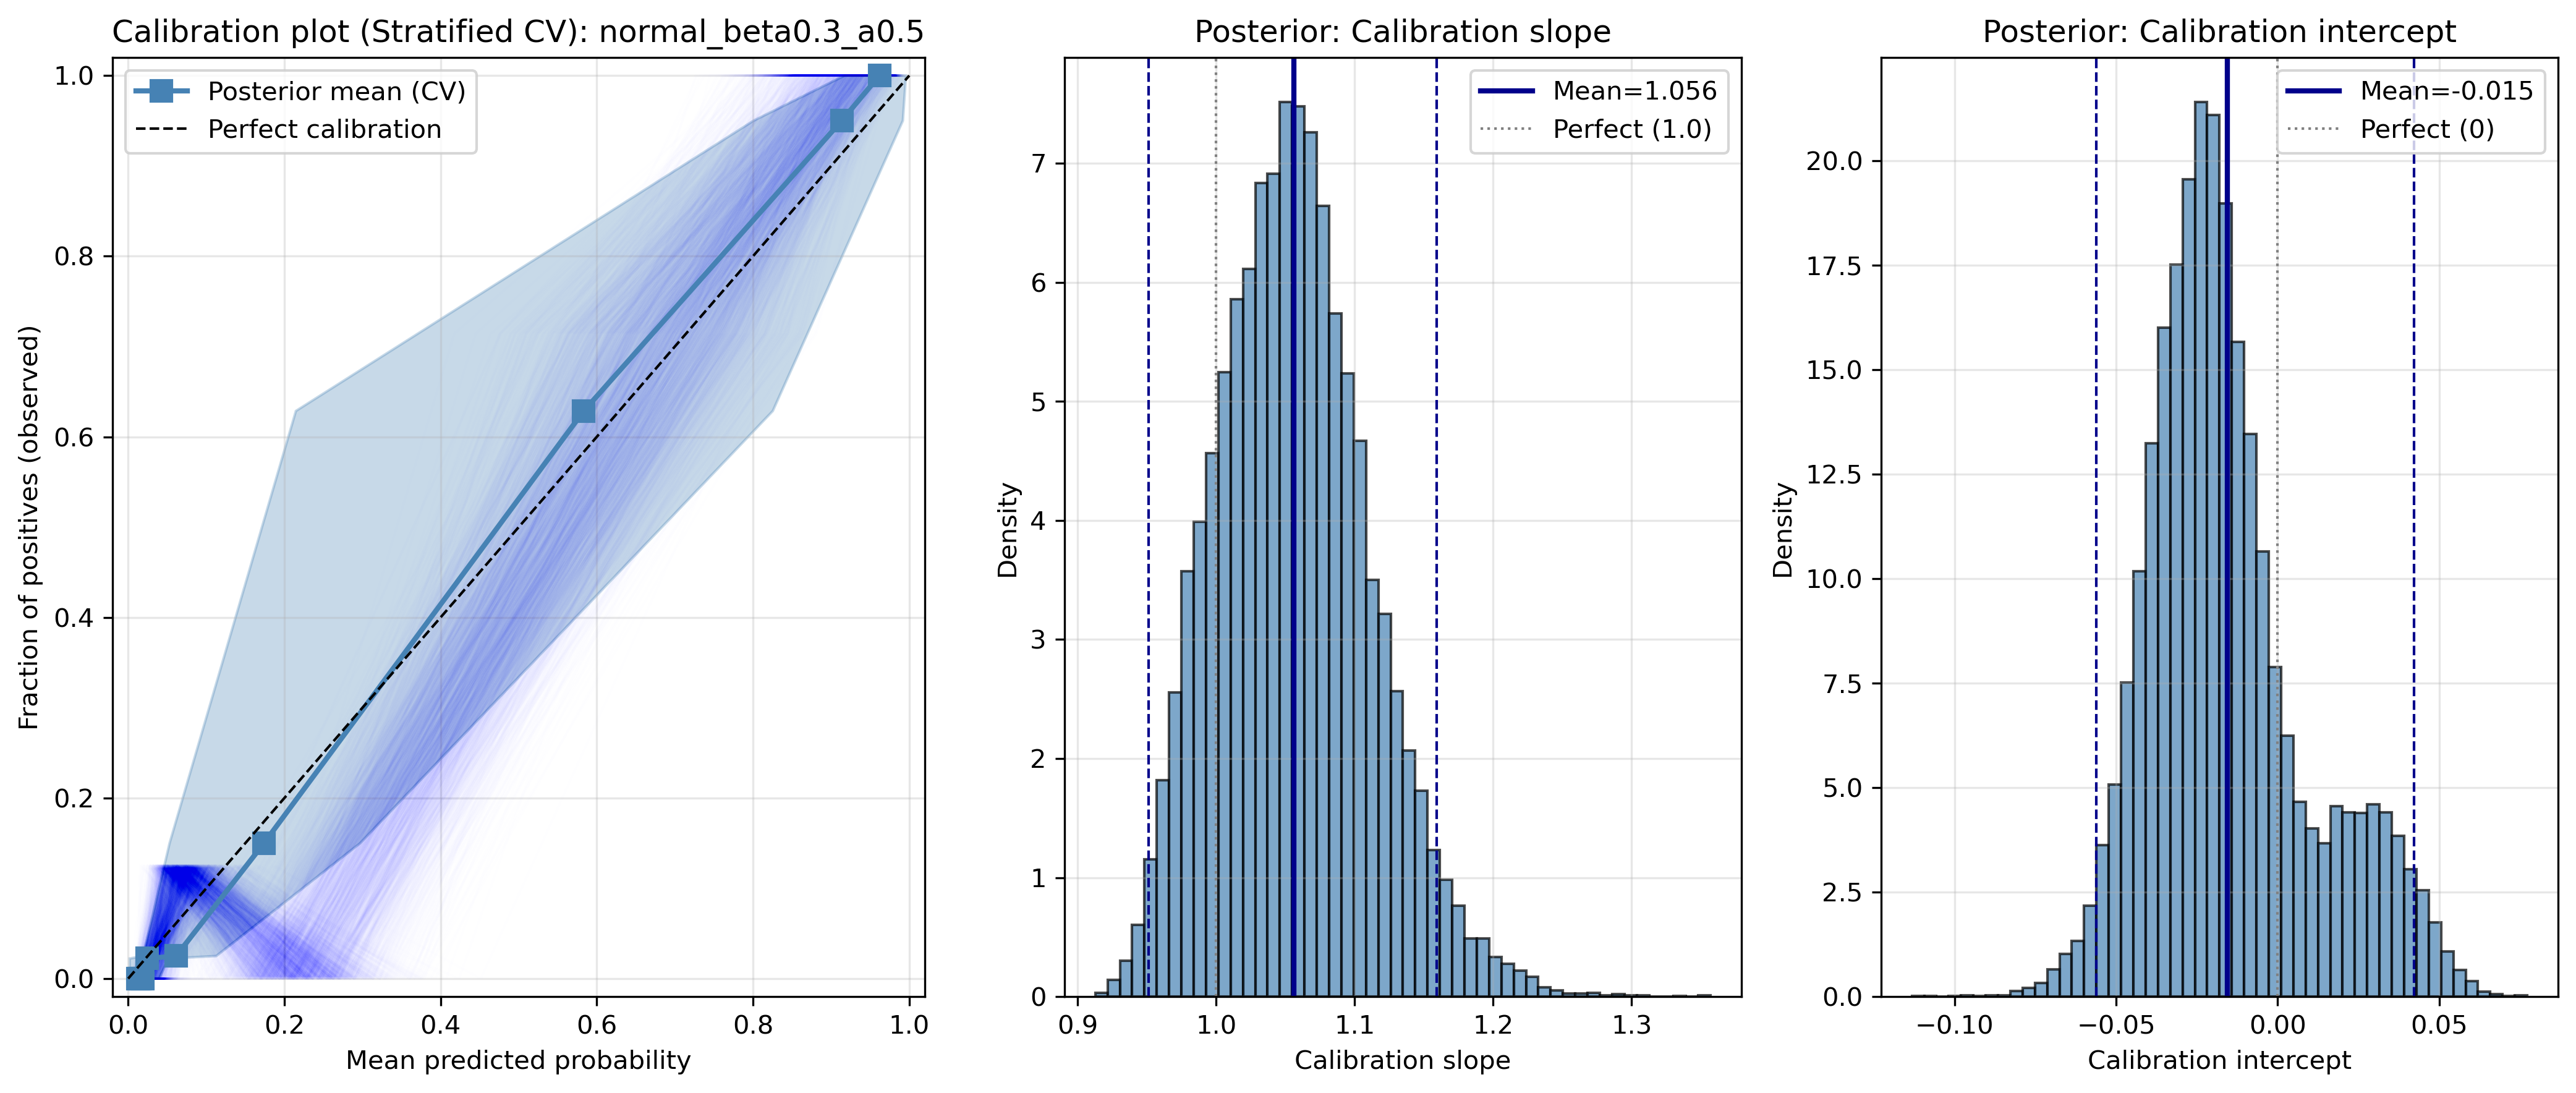
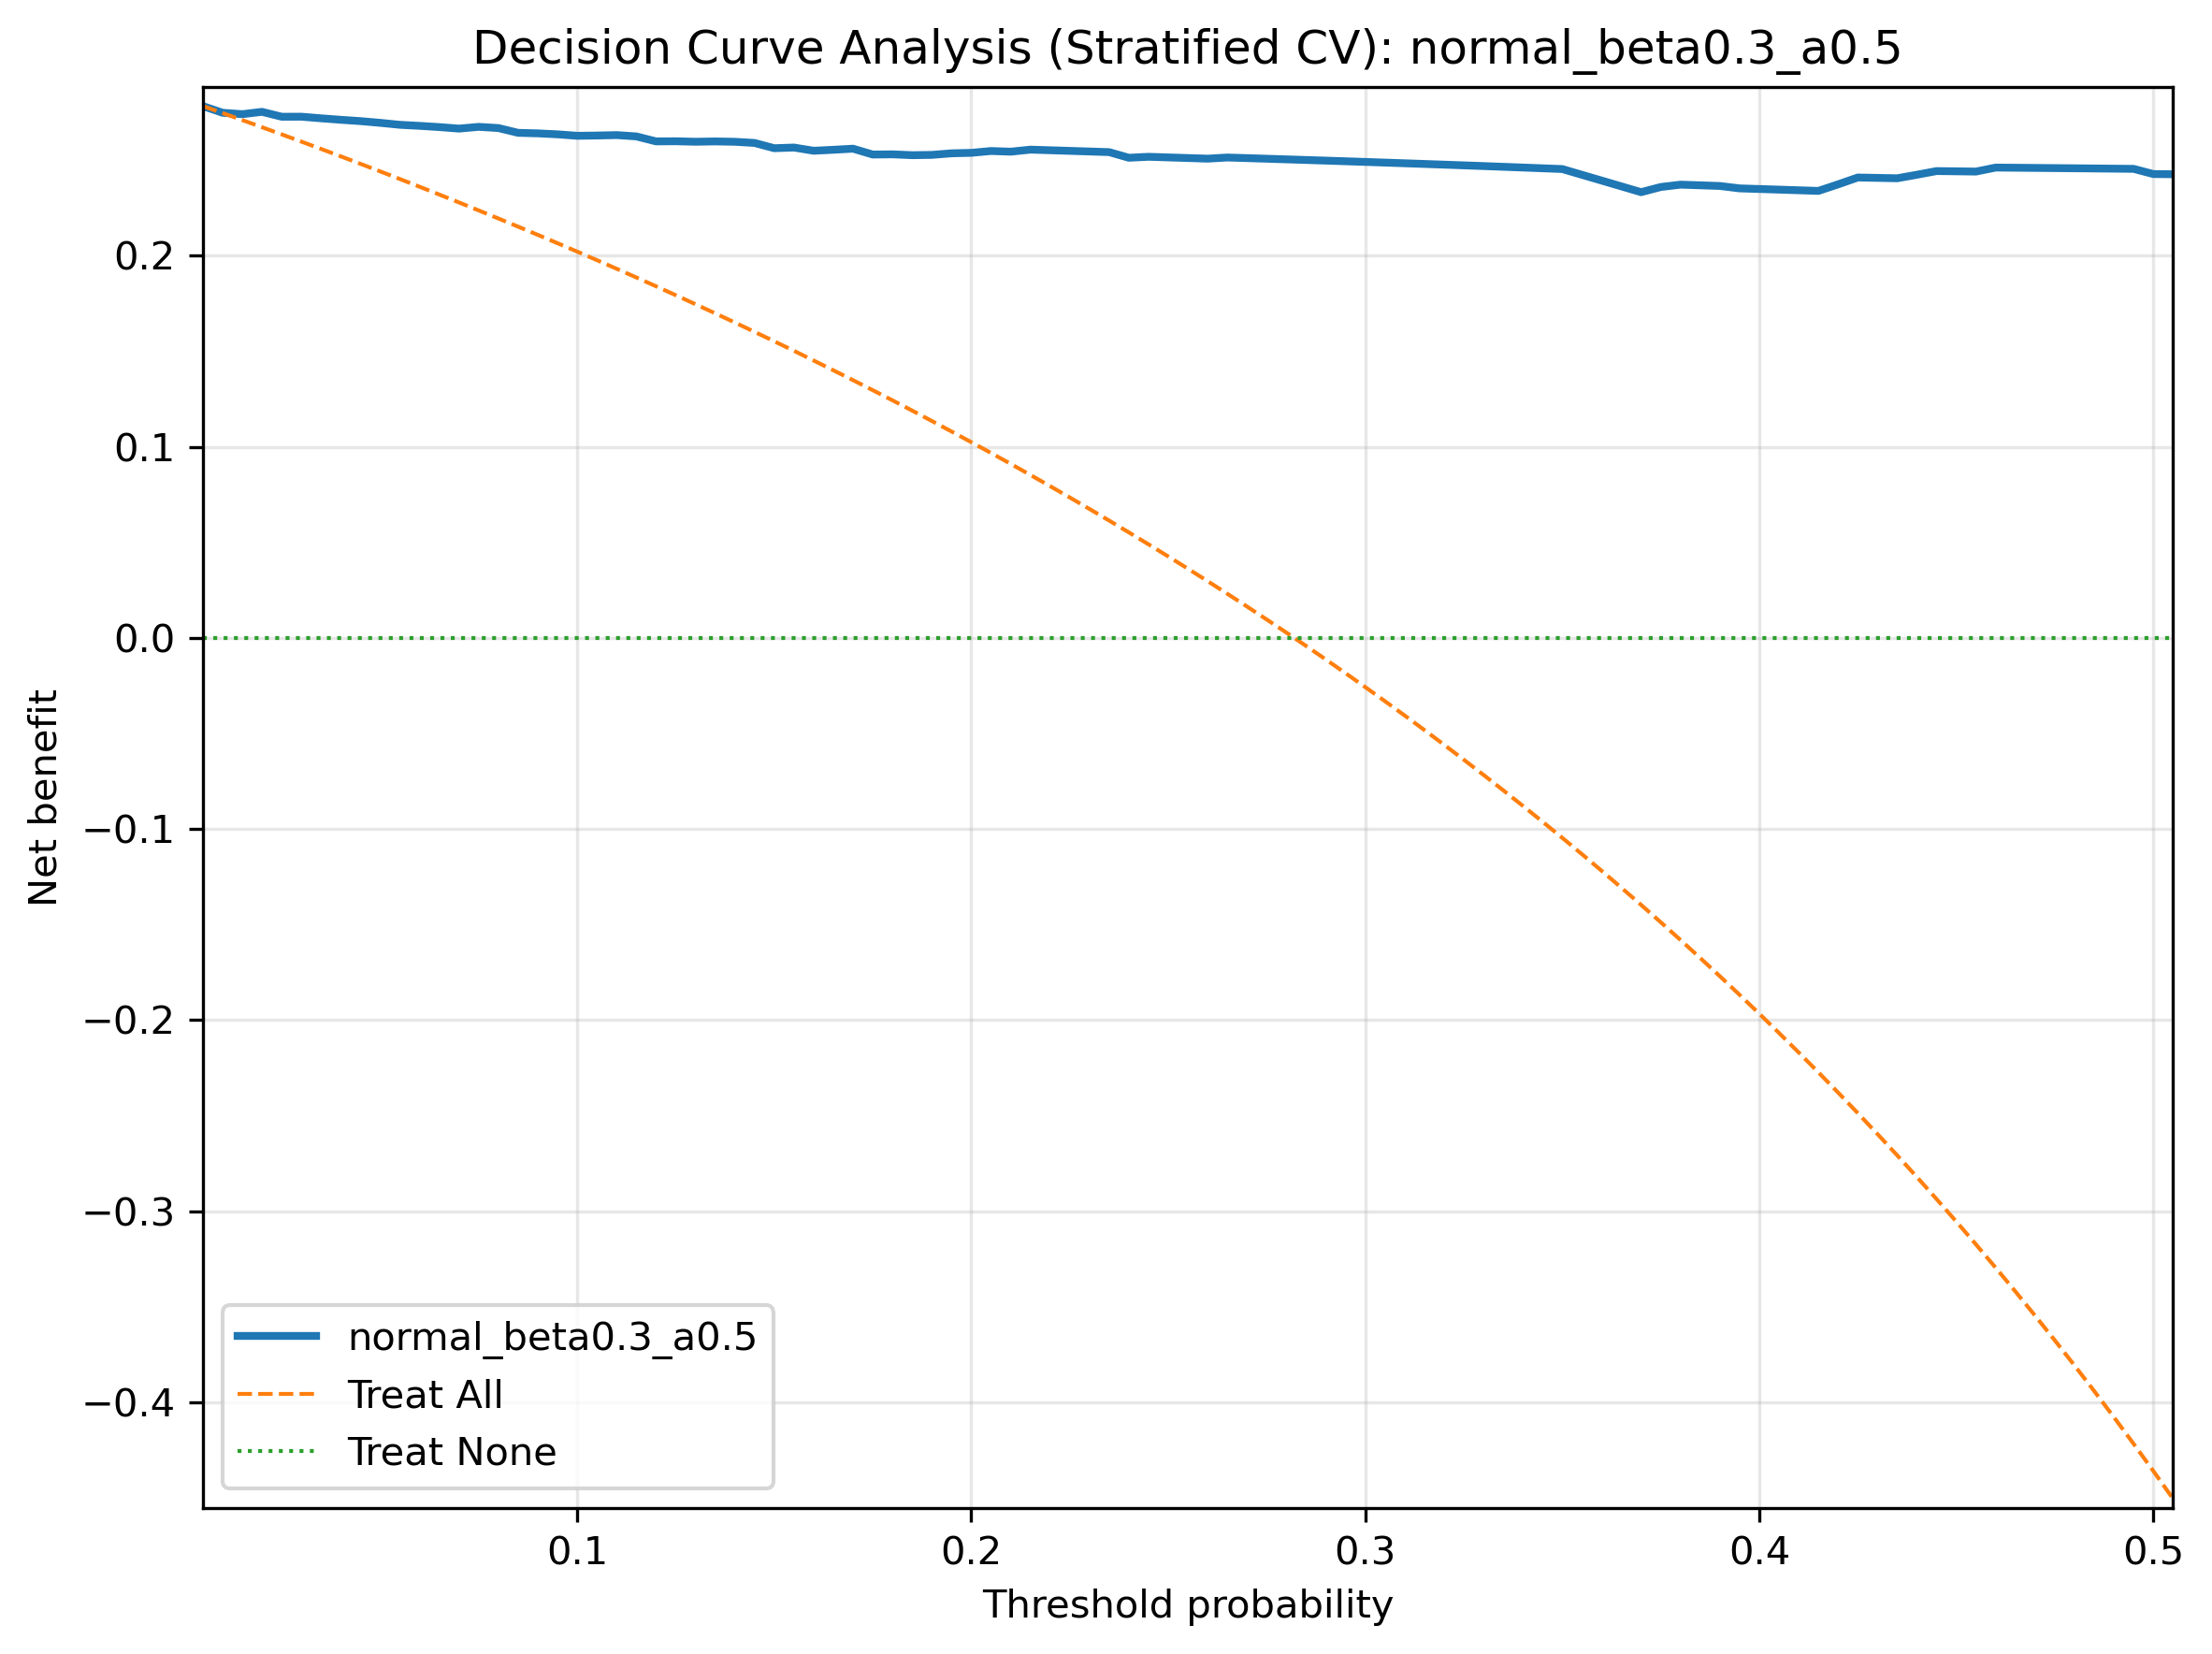
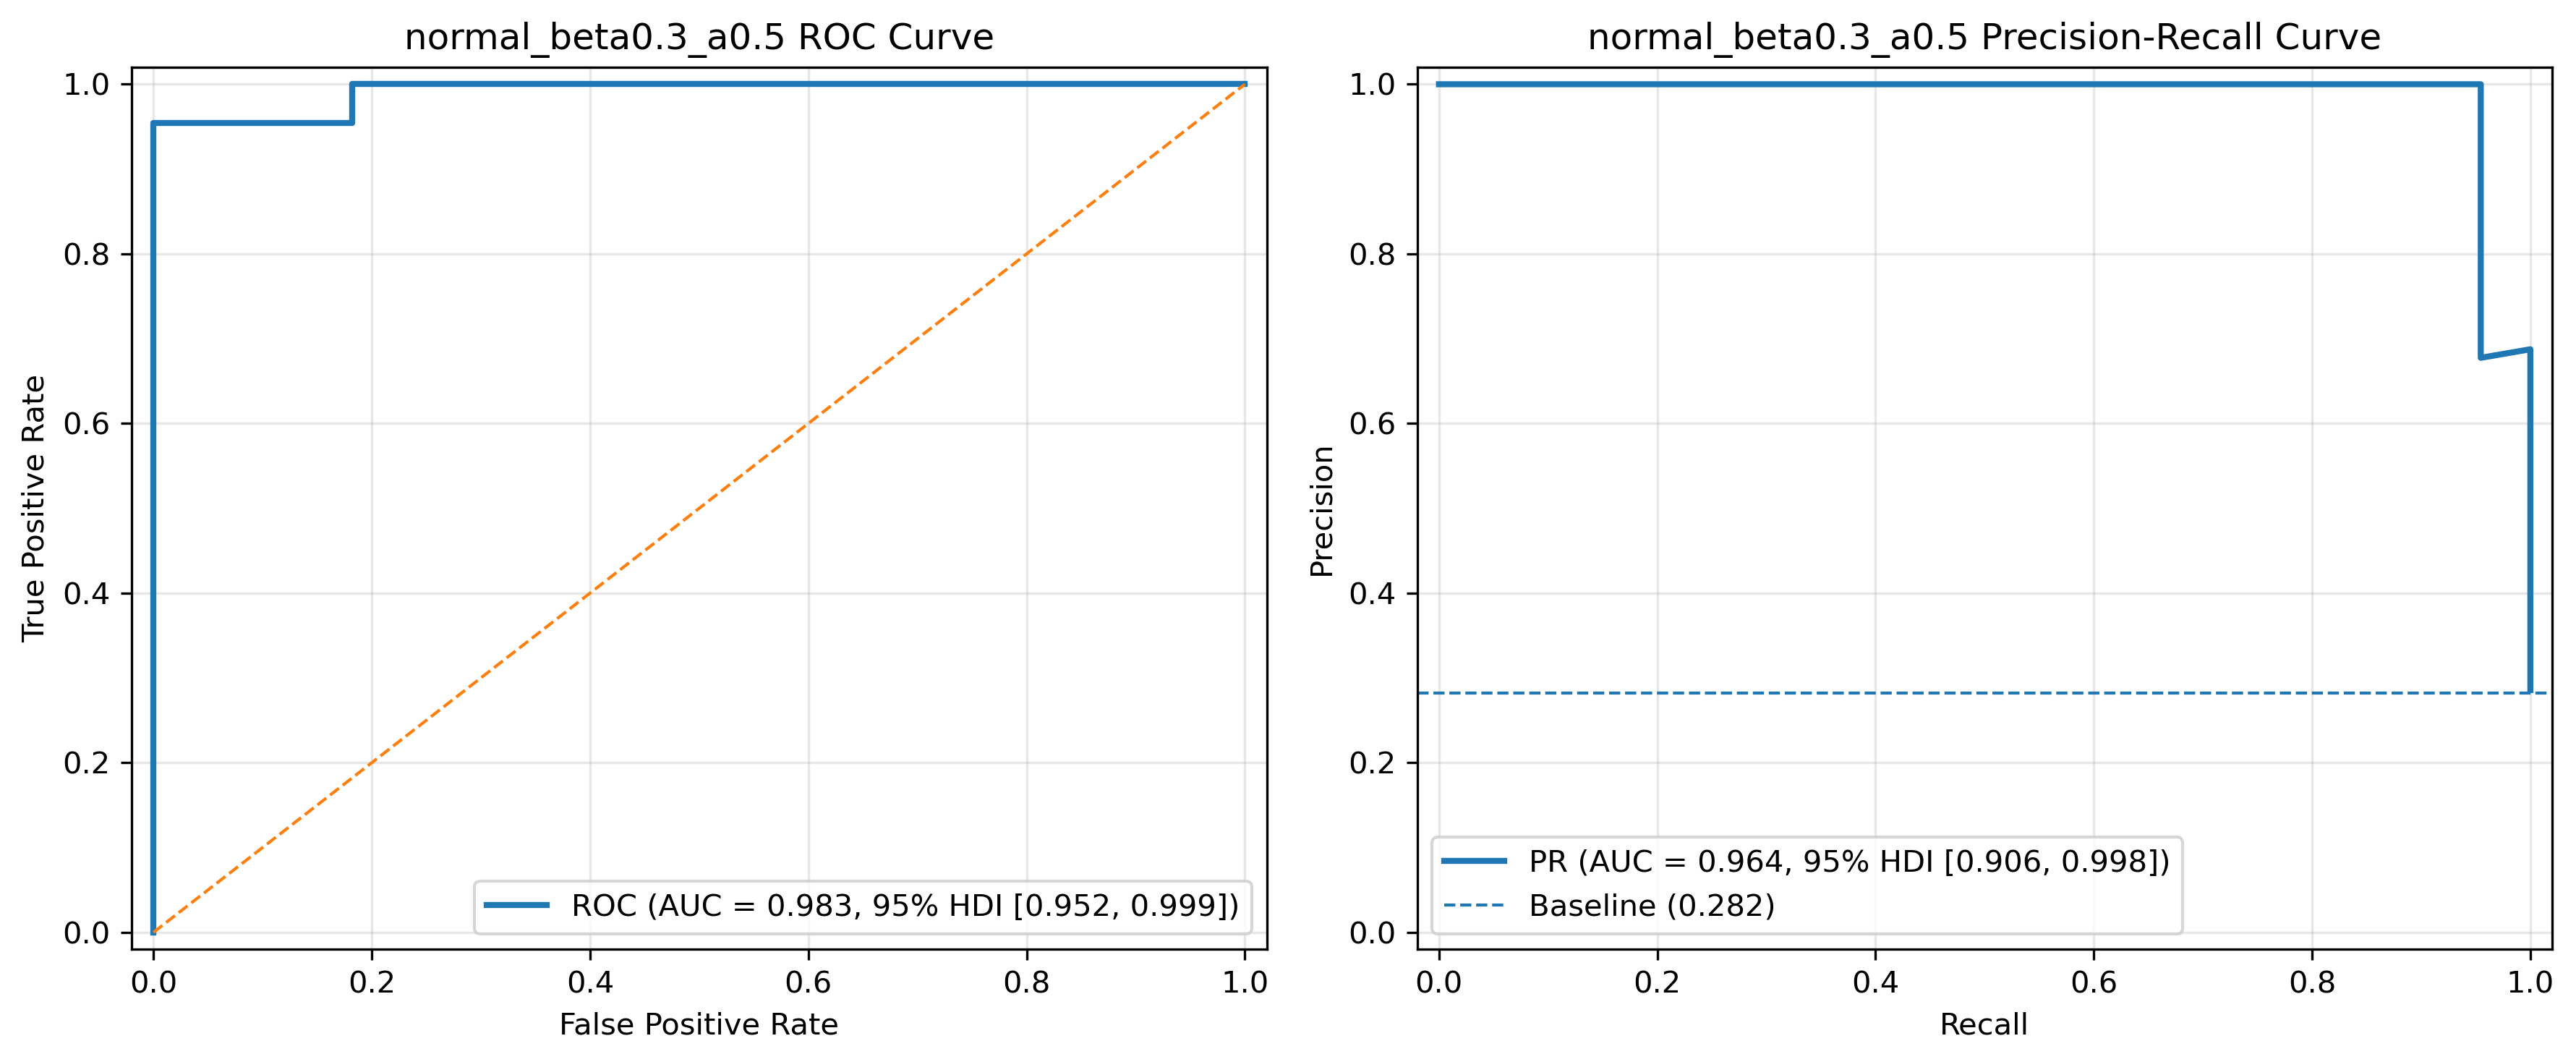
概要) 慢性腎疾患(CKD)患者の透析移行リスクを推定するために、PyMC を用いたMCMCベイズロジスティック回帰モデルを構築し、NumPyro(JAX backend)による高速サンプリングを用いて解析を行いました。対象データは、2304名中31名が透析移行という極めて“低イベント”構造であり、通常のロジスティック回帰では不安定な結果となります。そのため本解析では、近年のベイズ統計のガイドラインに沿って、事前感度分析(prior sensitivity)による事前分布(prior)の適切な設定、高品質なMCMCによる事後(posterior)推定、予測性能評価、再現性のあるコード設計といった総合的なベイズ統計ワークフローを採用しています。ベイズ推定は約1.35%という非常に低い透析イベント率でも、パラメータが発散しない、オッズ比が安定的に推定できる、不確実性(HDI)が明確に示せるというメリットがあります。
結論)
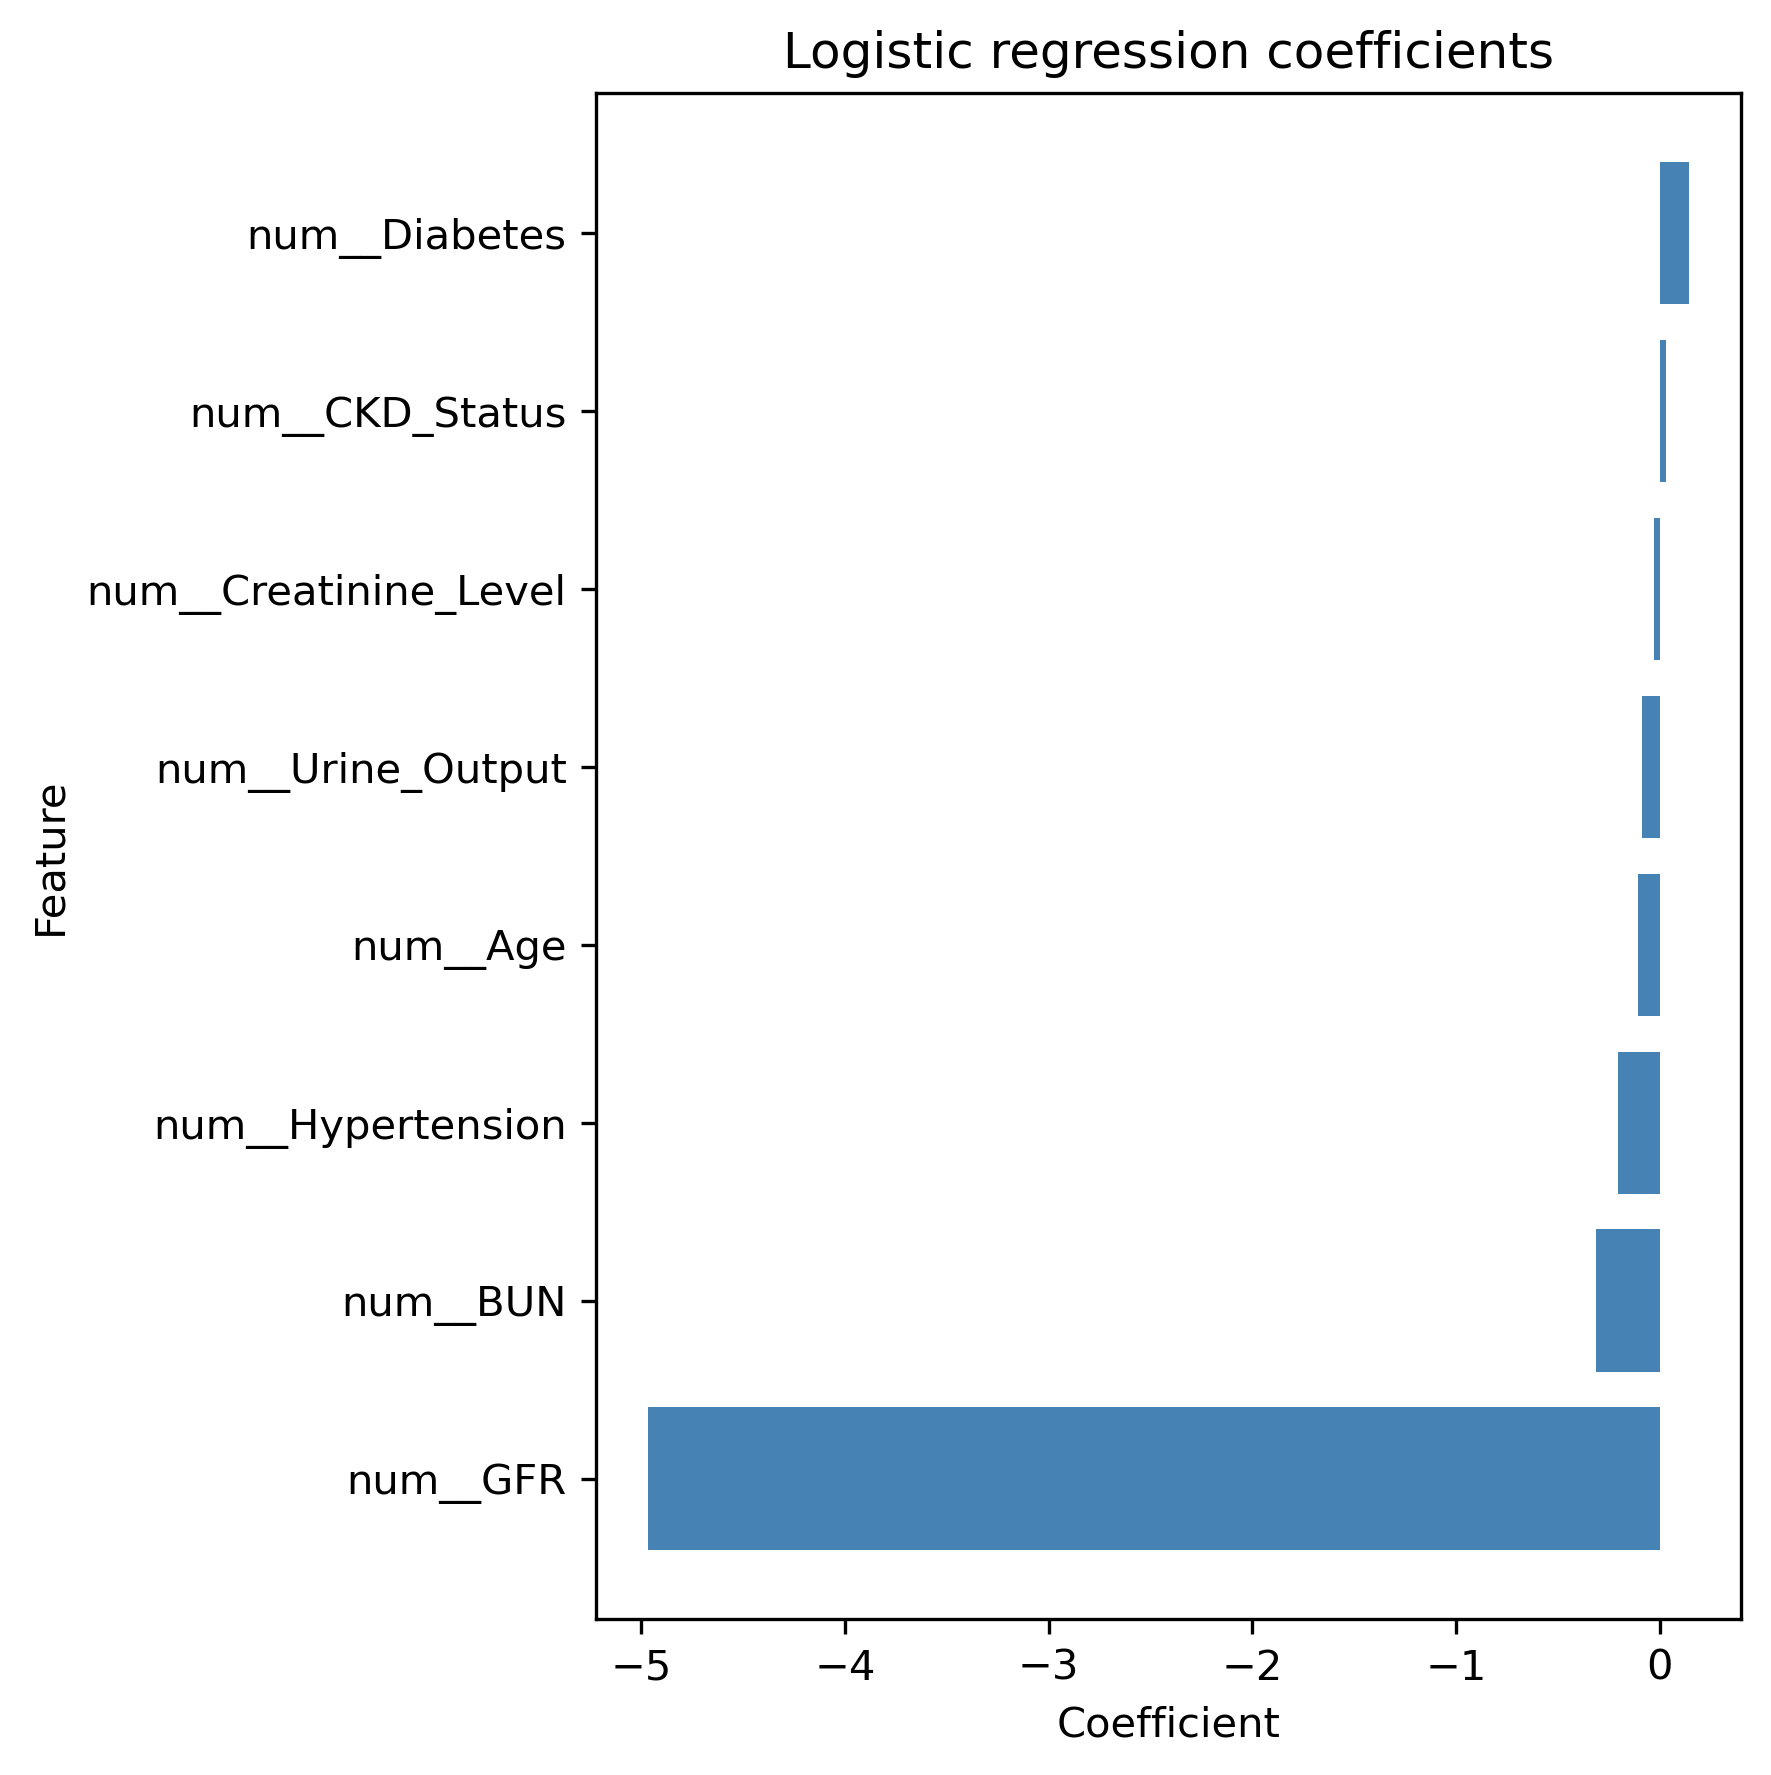
本研究で構築したMCMCベイズロジスティック回帰モデルは透析イベントの予測において、サンプリング品質、モデル適合性、識別性能、キャリブレーション、臨床意思決定上の有用性のすべての観点で良好な性能を示しました。GFRは透析イベントの最も強い予測因子であり、GFRの低下は透析イベントリスクの顕著な増加と関連していることが示されました。
prior specification · MCMC · stratified cross-validation · ROC-AUC · calibration · decision curve analysis
Bayesian Oncology
MCMC階層ベイズロジスティック回帰モデルによる甲状腺がん患者の再発リスクの予測
概要)
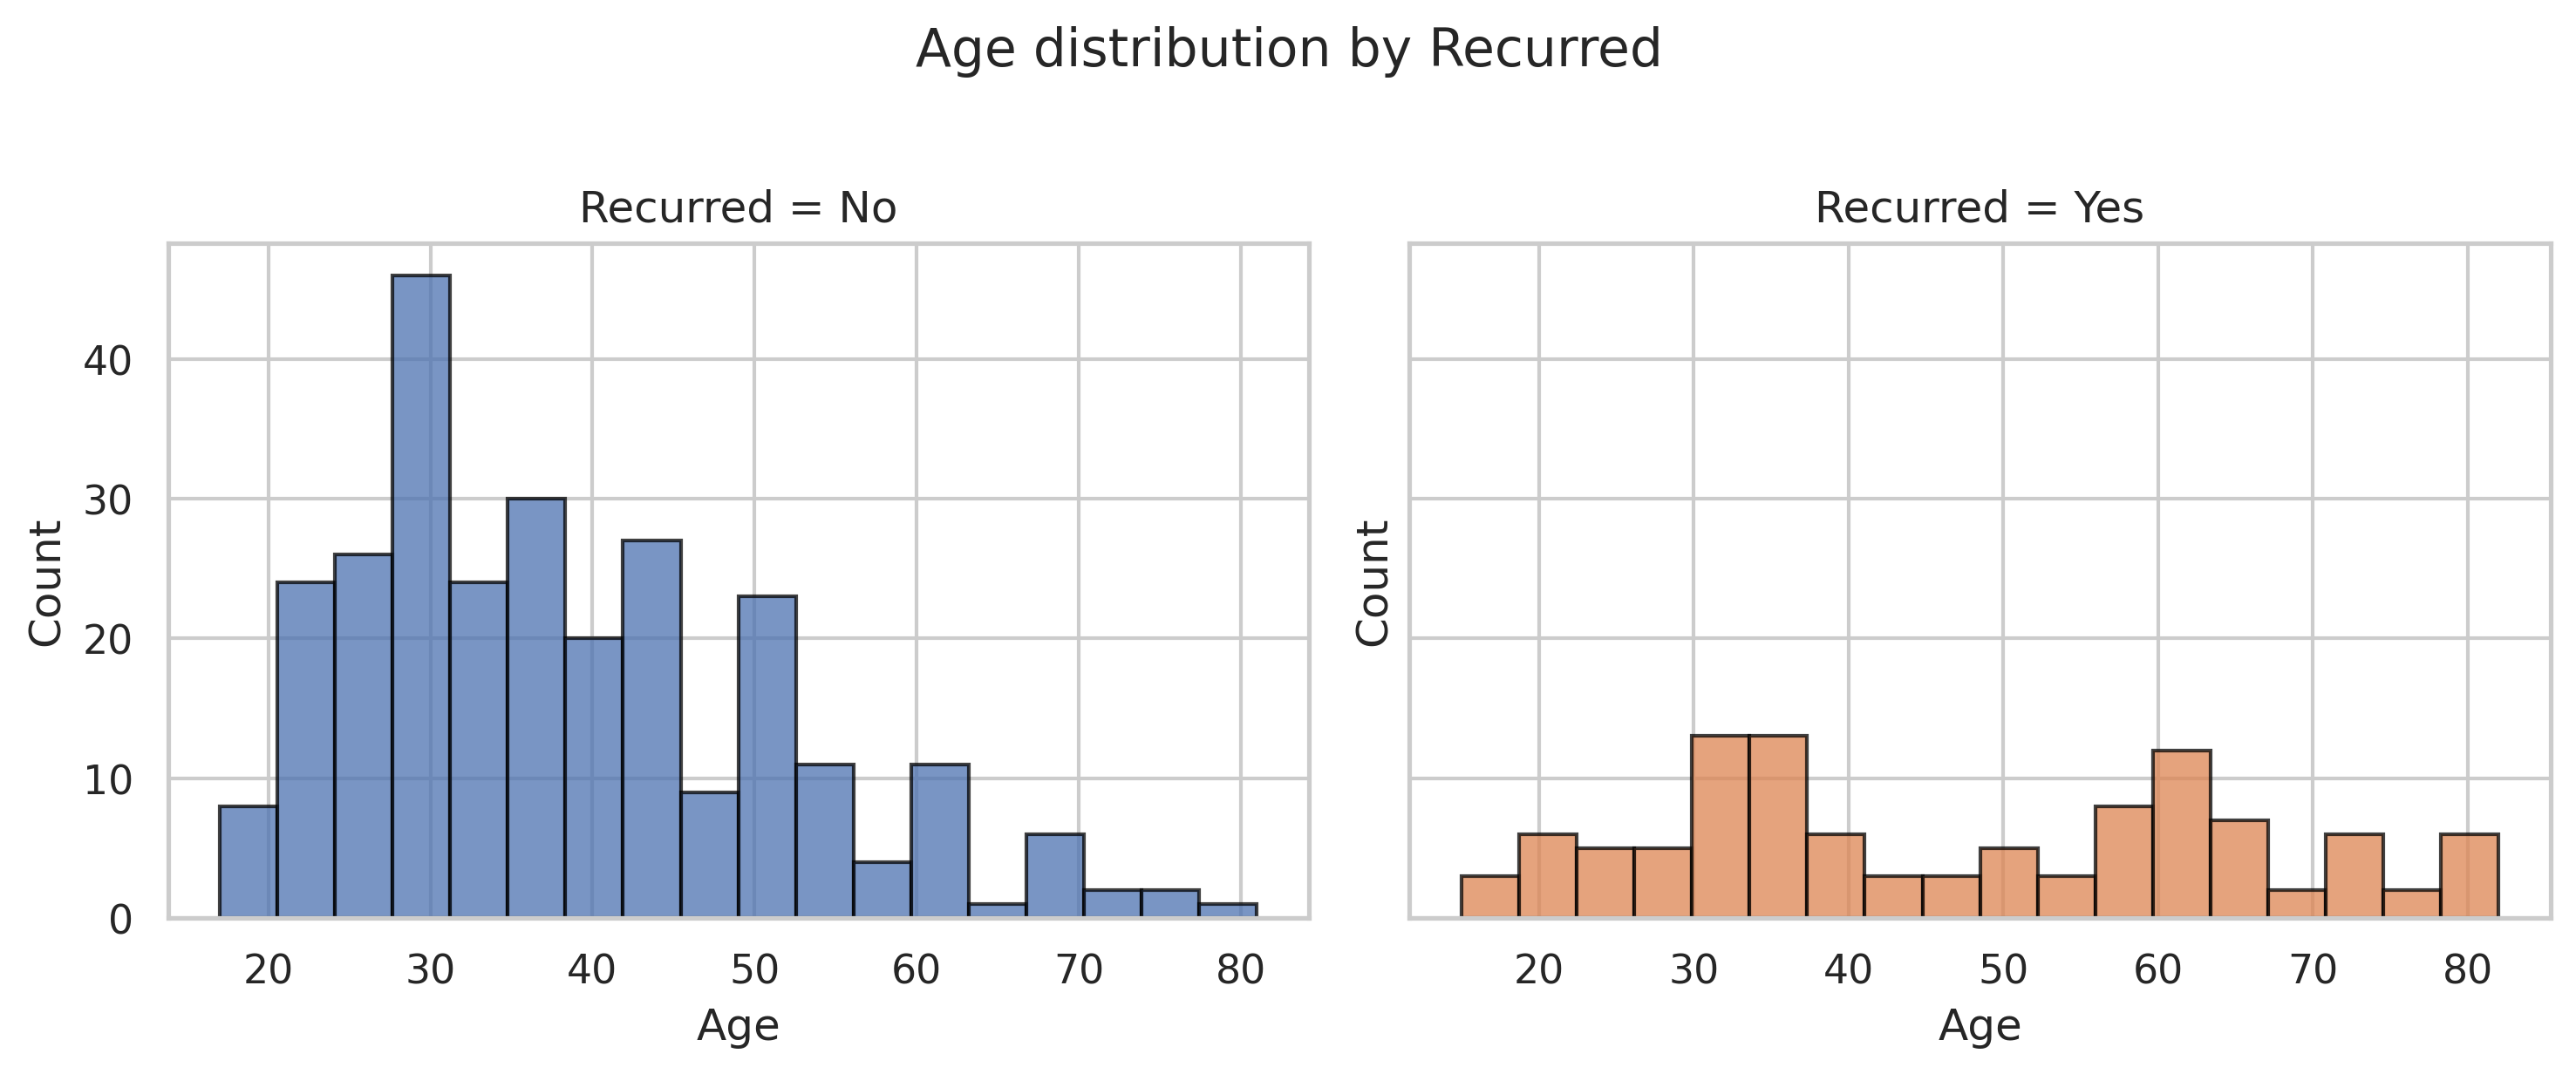
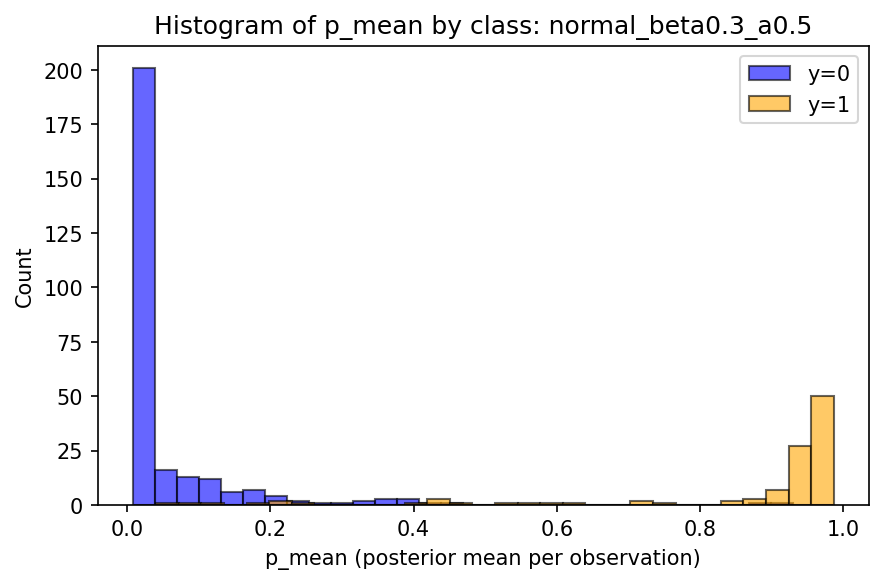
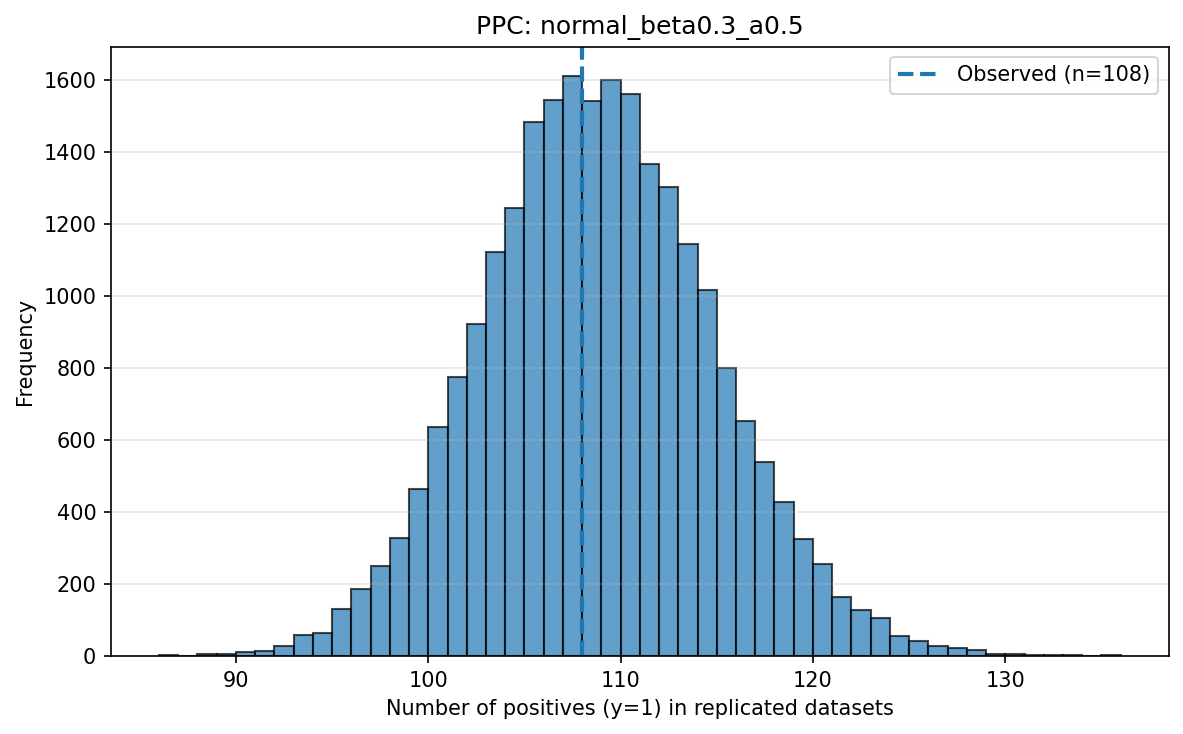
甲状腺がん患者の再発リスクを予測するために、PyMCを用いたMCMC階層ベイズロジスティック回帰モデルを構築し、NumPyro(JAX backend)による高速サンプリングを用いて解析を行いました。対象データでは、383例中108例に再発が認められ、15個のカテゴリ変数のうち7変数が4~7水準を含んでいたため、通常のロジスティック回帰では少ないサンプル数や多カテゴリ構造に起因する推定の不安定性が生じやすいと考えられました。そこで本解析では、ベイズモデリングの実務的な考え方に基づき、症例数の少ないカテゴリの統合、主要カテゴリ変数の階層化、事前感度分析(prior sensitivity)による事前分布の検討、MCMC による事後分布推定、posterior predictive check、LOOによる予測性能評価、キャリブレーション評価を含む総合的なベイズ統計ワークフローを採用しました。階層ベイズロジスティック回帰モデルは、カテゴリ数が多く一部のカテゴリの症例数が少ない状況においても、極端な推定を抑えつつオッズ比をより安定的に推定し、不確実性を HDI として明示できる点に利点があります。
結論)
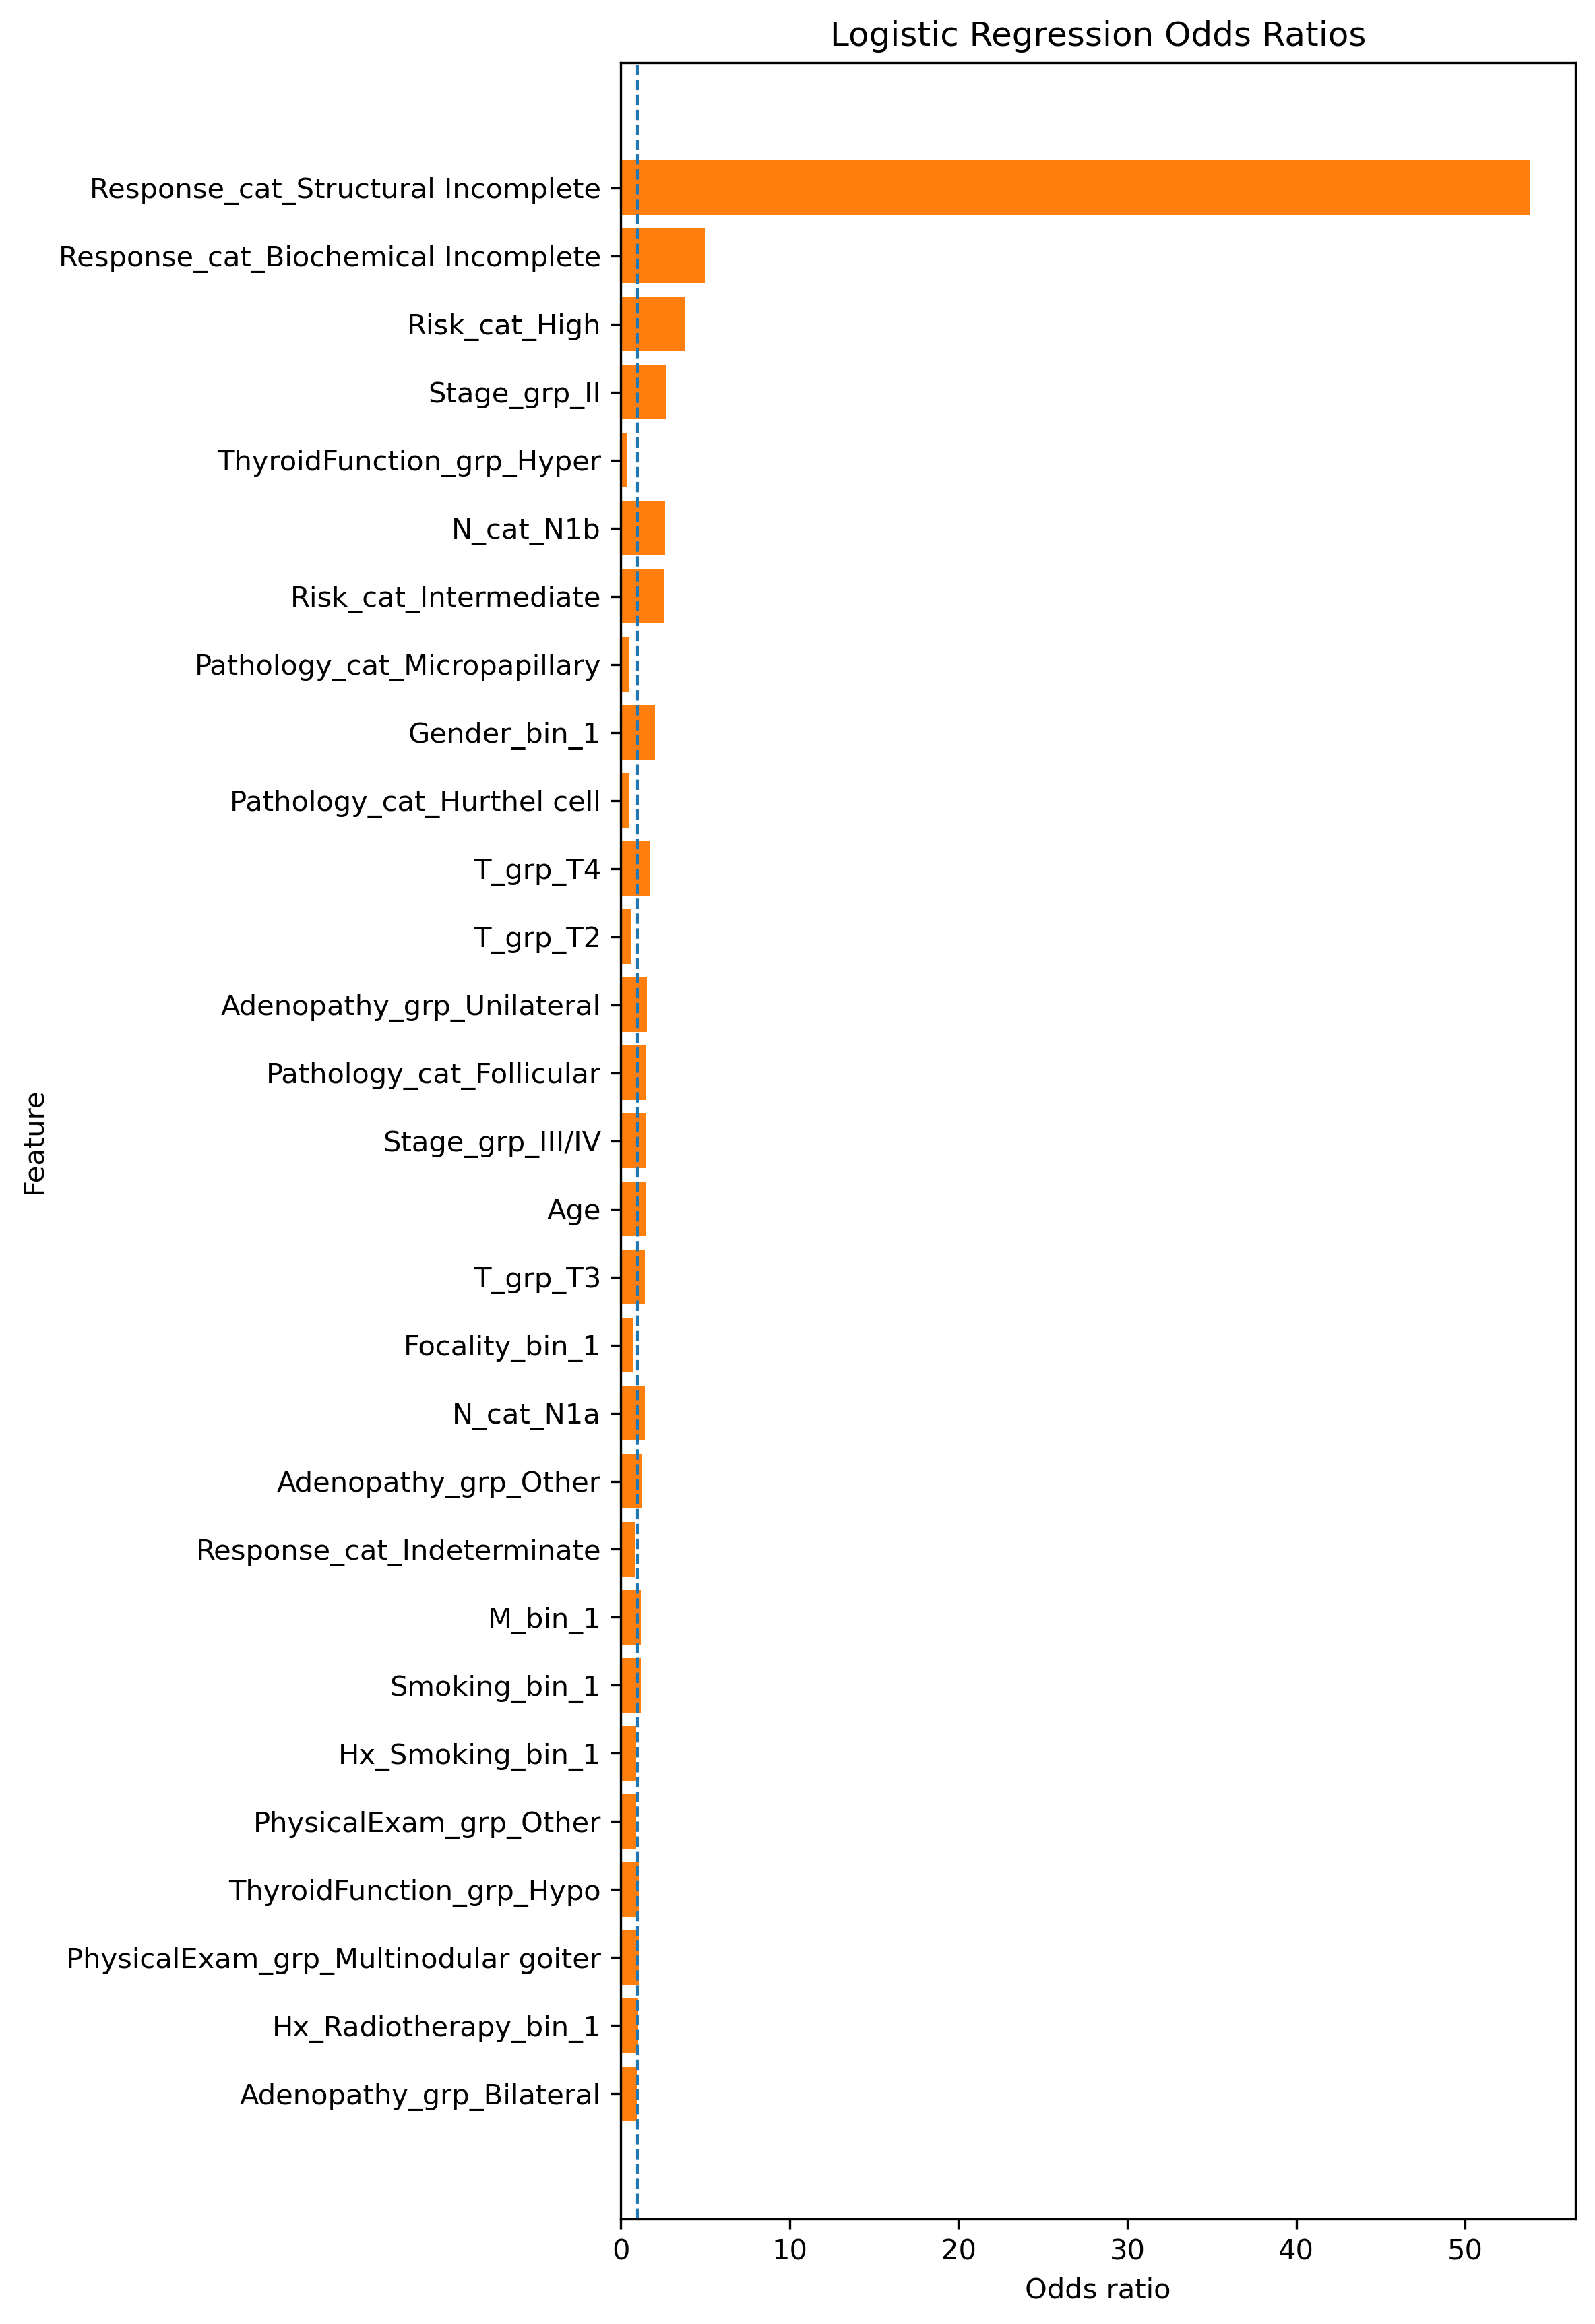
本研究で構築したMCMCベイズロジスティック回帰モデルは甲状腺がんの再発リスク予測において、サンプリング品質、モデル適合性、識別性能、キャリブレーション、臨床意思決定上の有用性のすべての観点で良好な性能を示しました。response_effectは再発率の最も強い予測因子であり、Structural Incompleteは再発リスクの顕著な増加と関連していることが示されました。
PyMC · hierarchical modeling · MCMC diagnostics · LOO comparison · posterior predictive checks
Machine Learning
血液検査データを用いた肝疾患の予測モデルの構築及び病態の分類
概要)
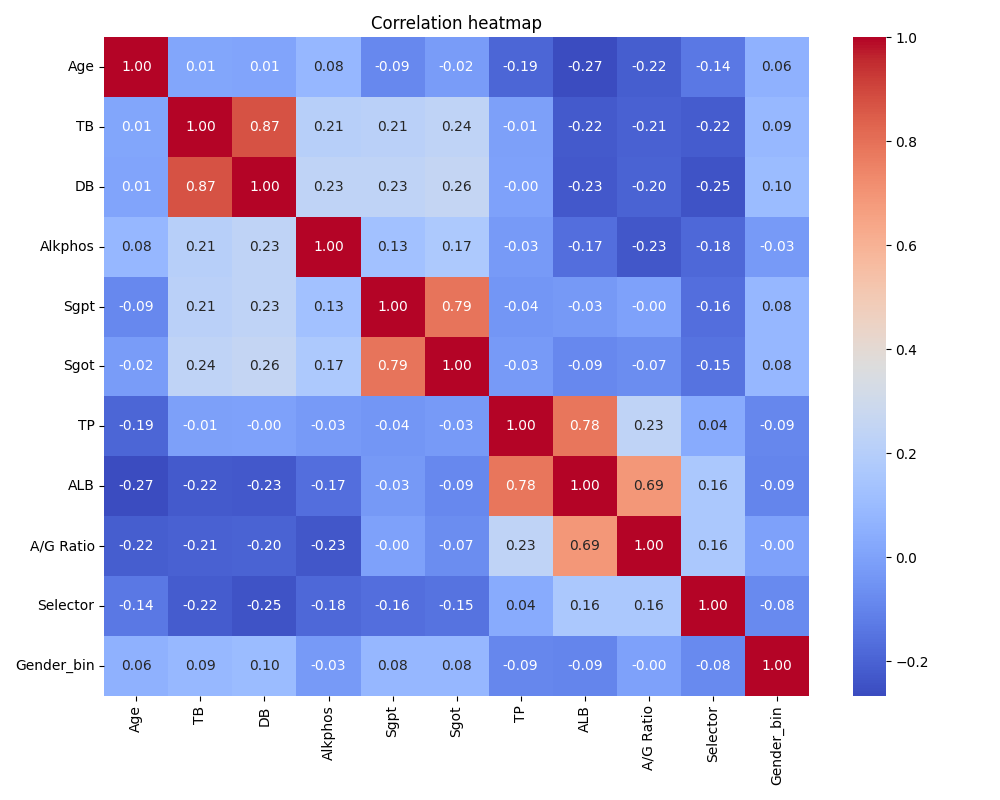
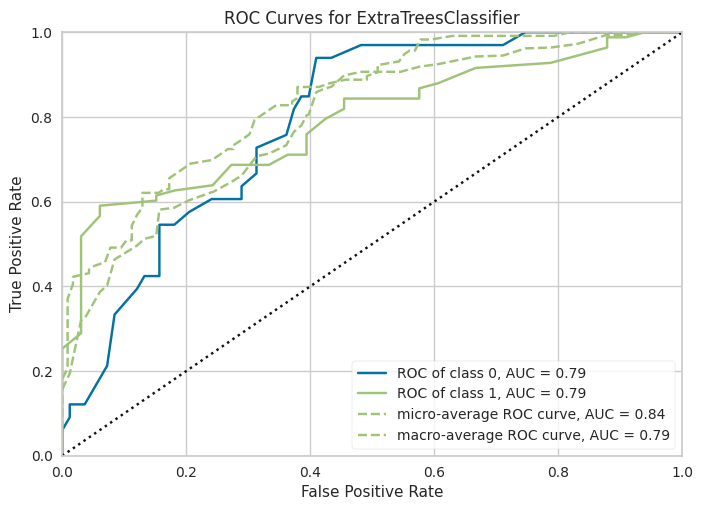
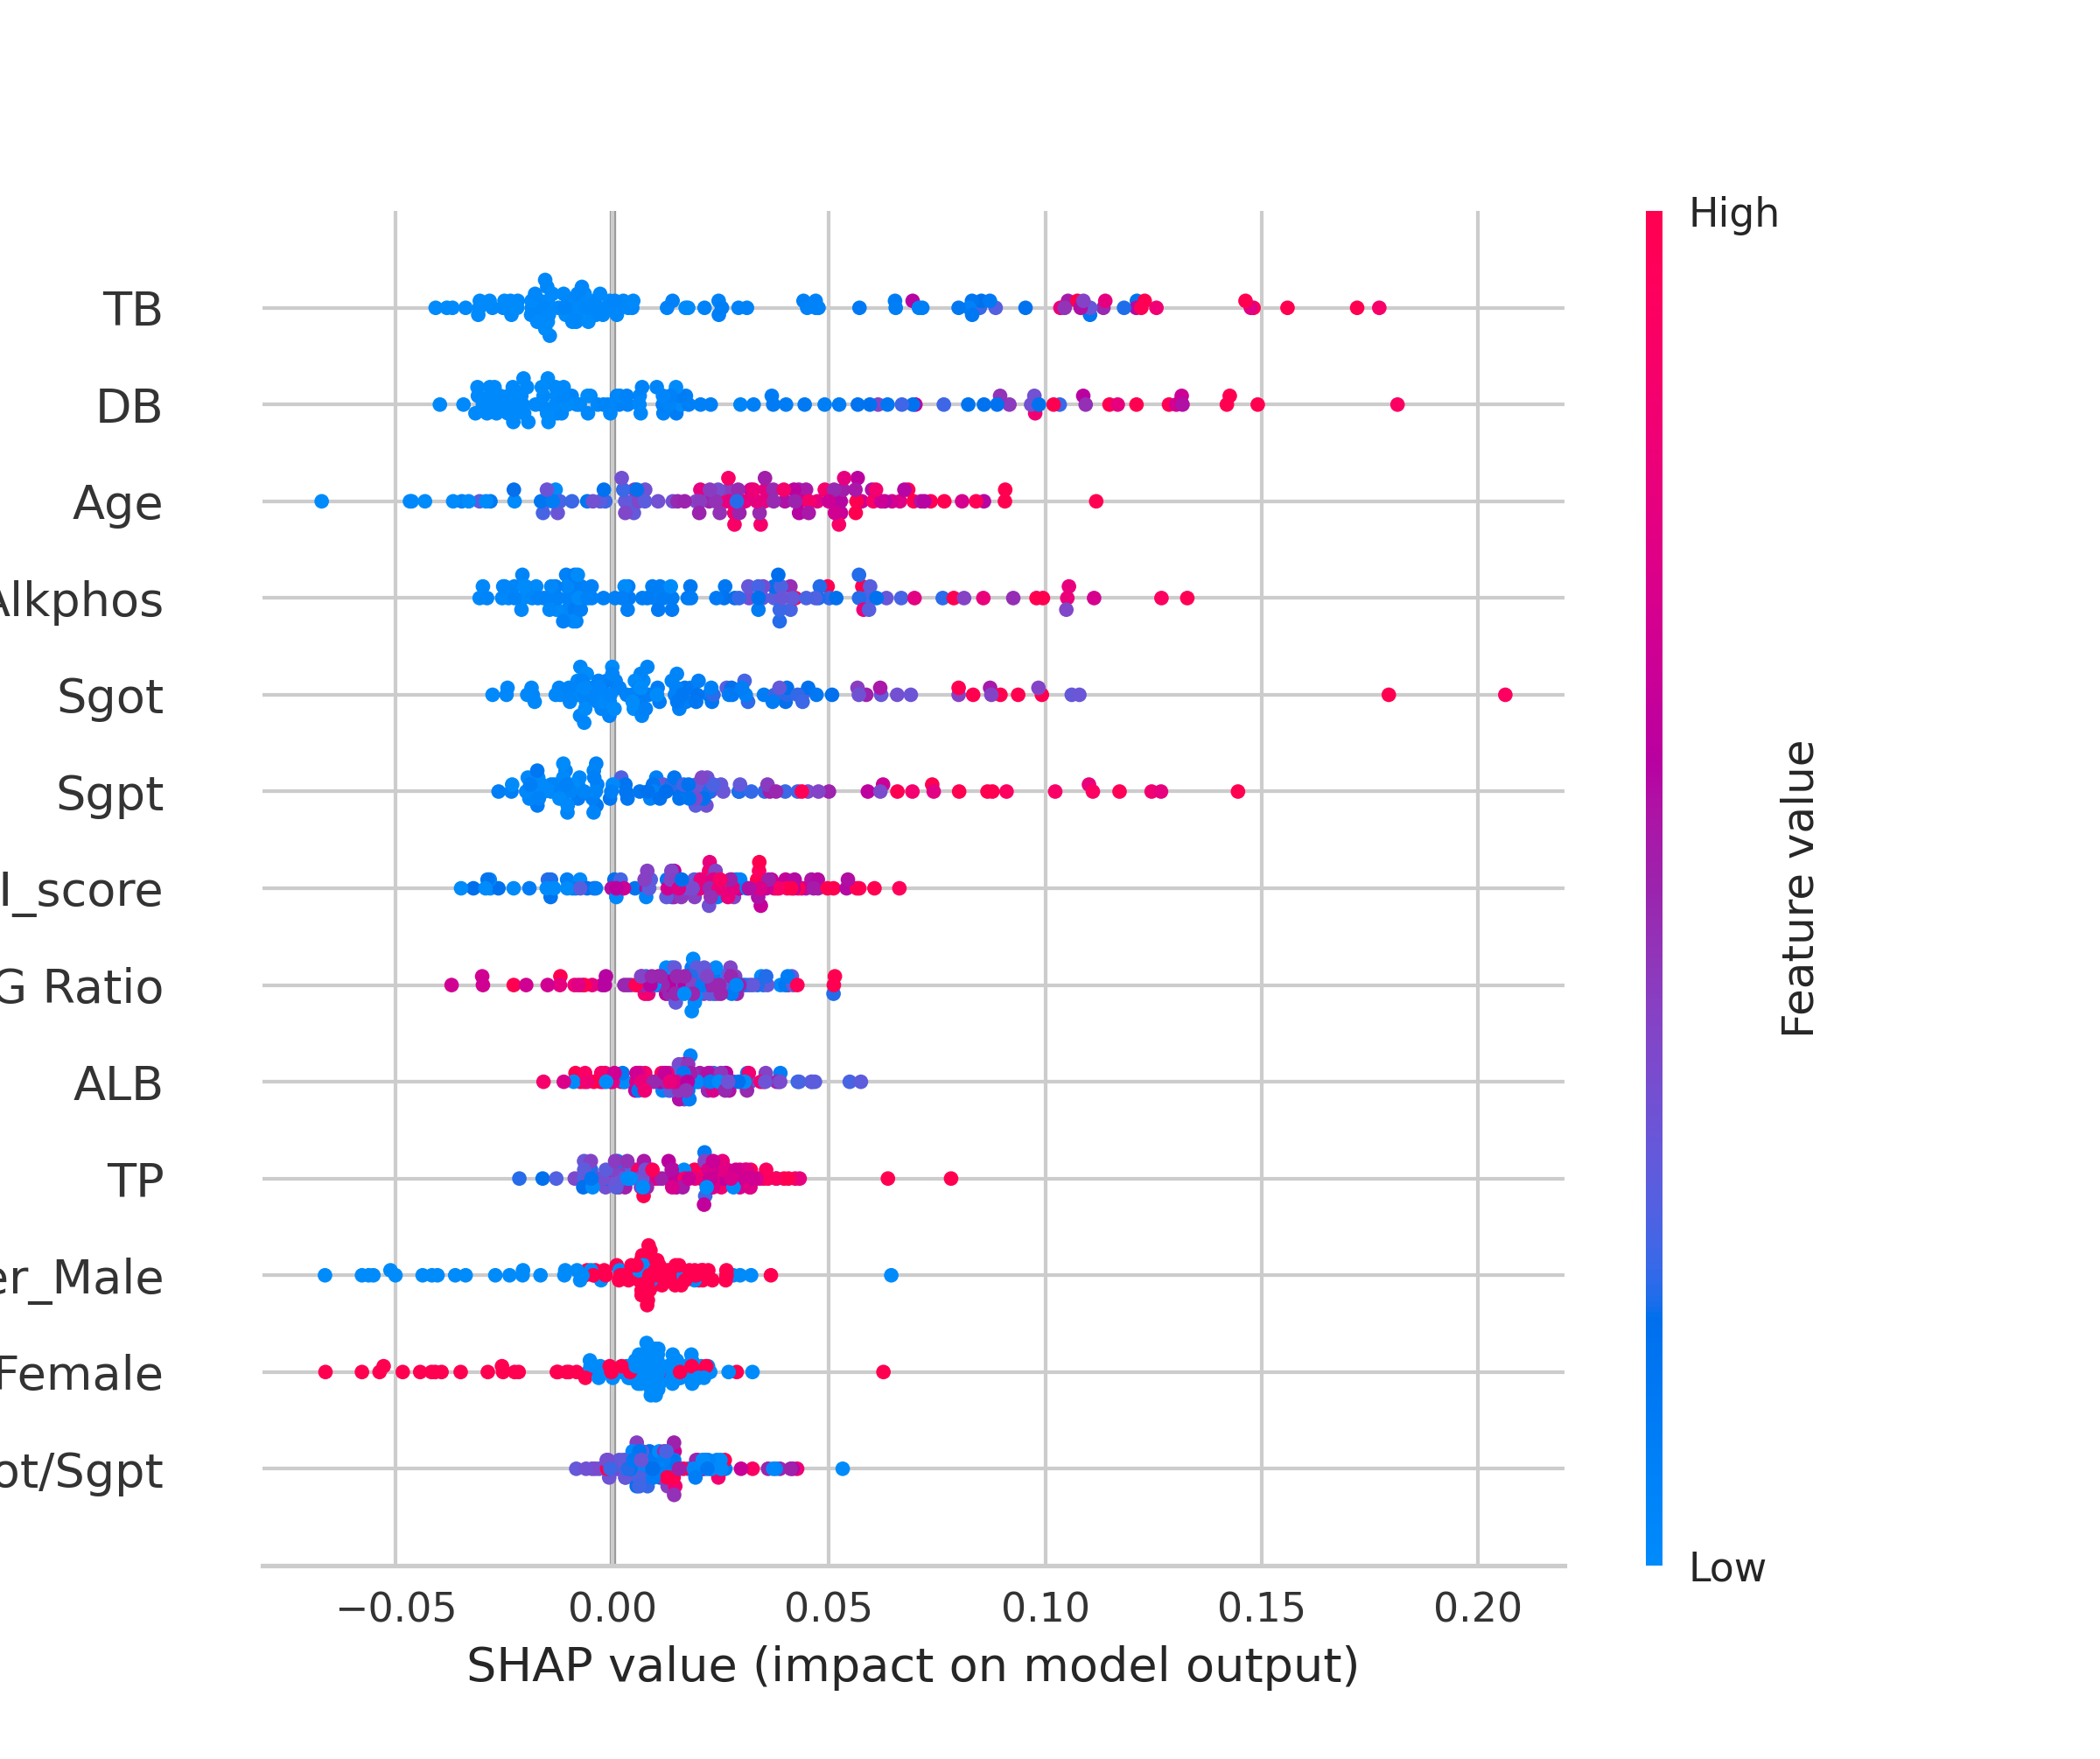
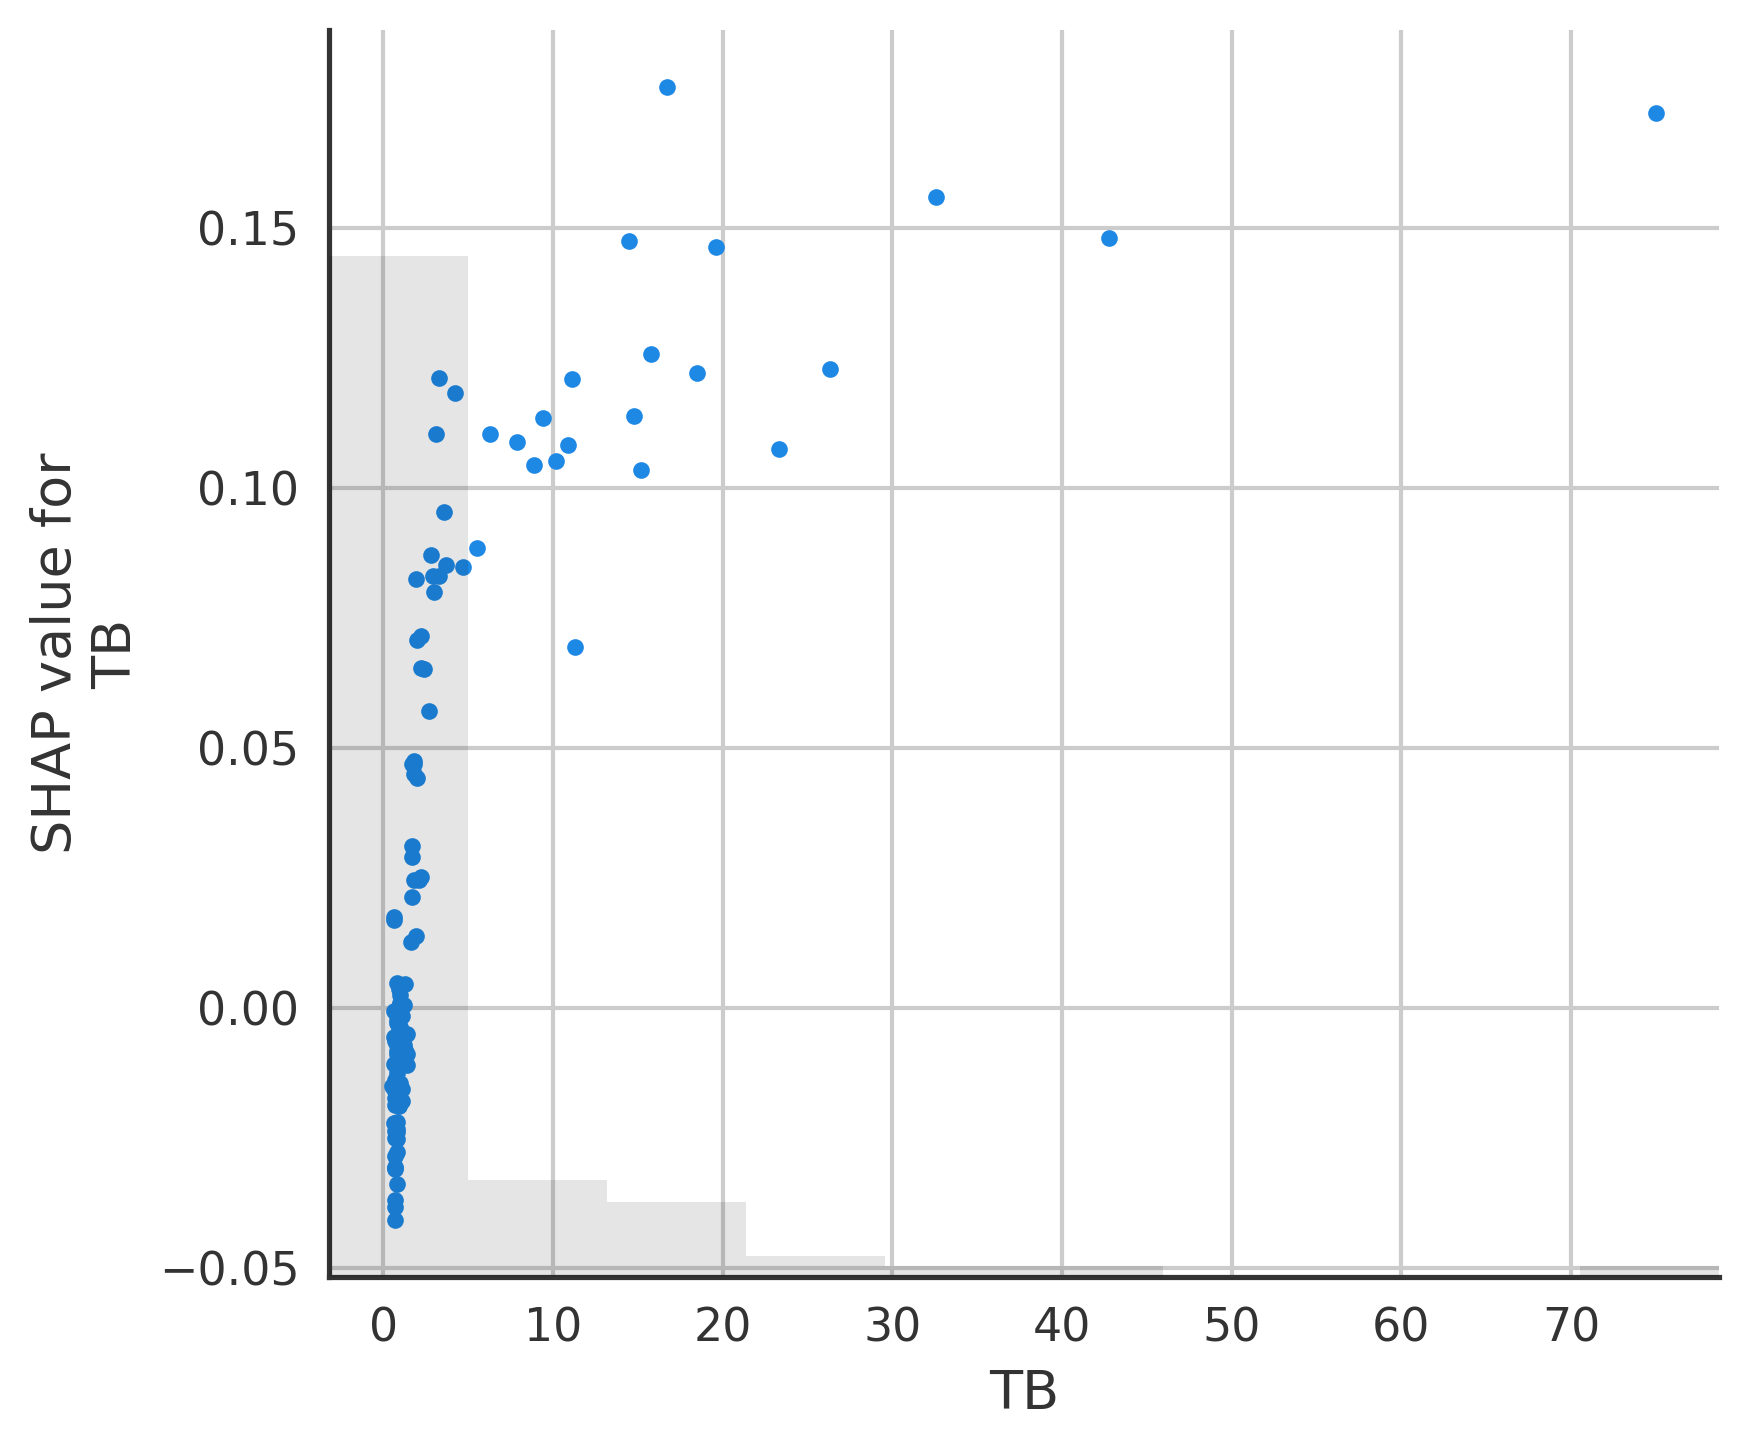
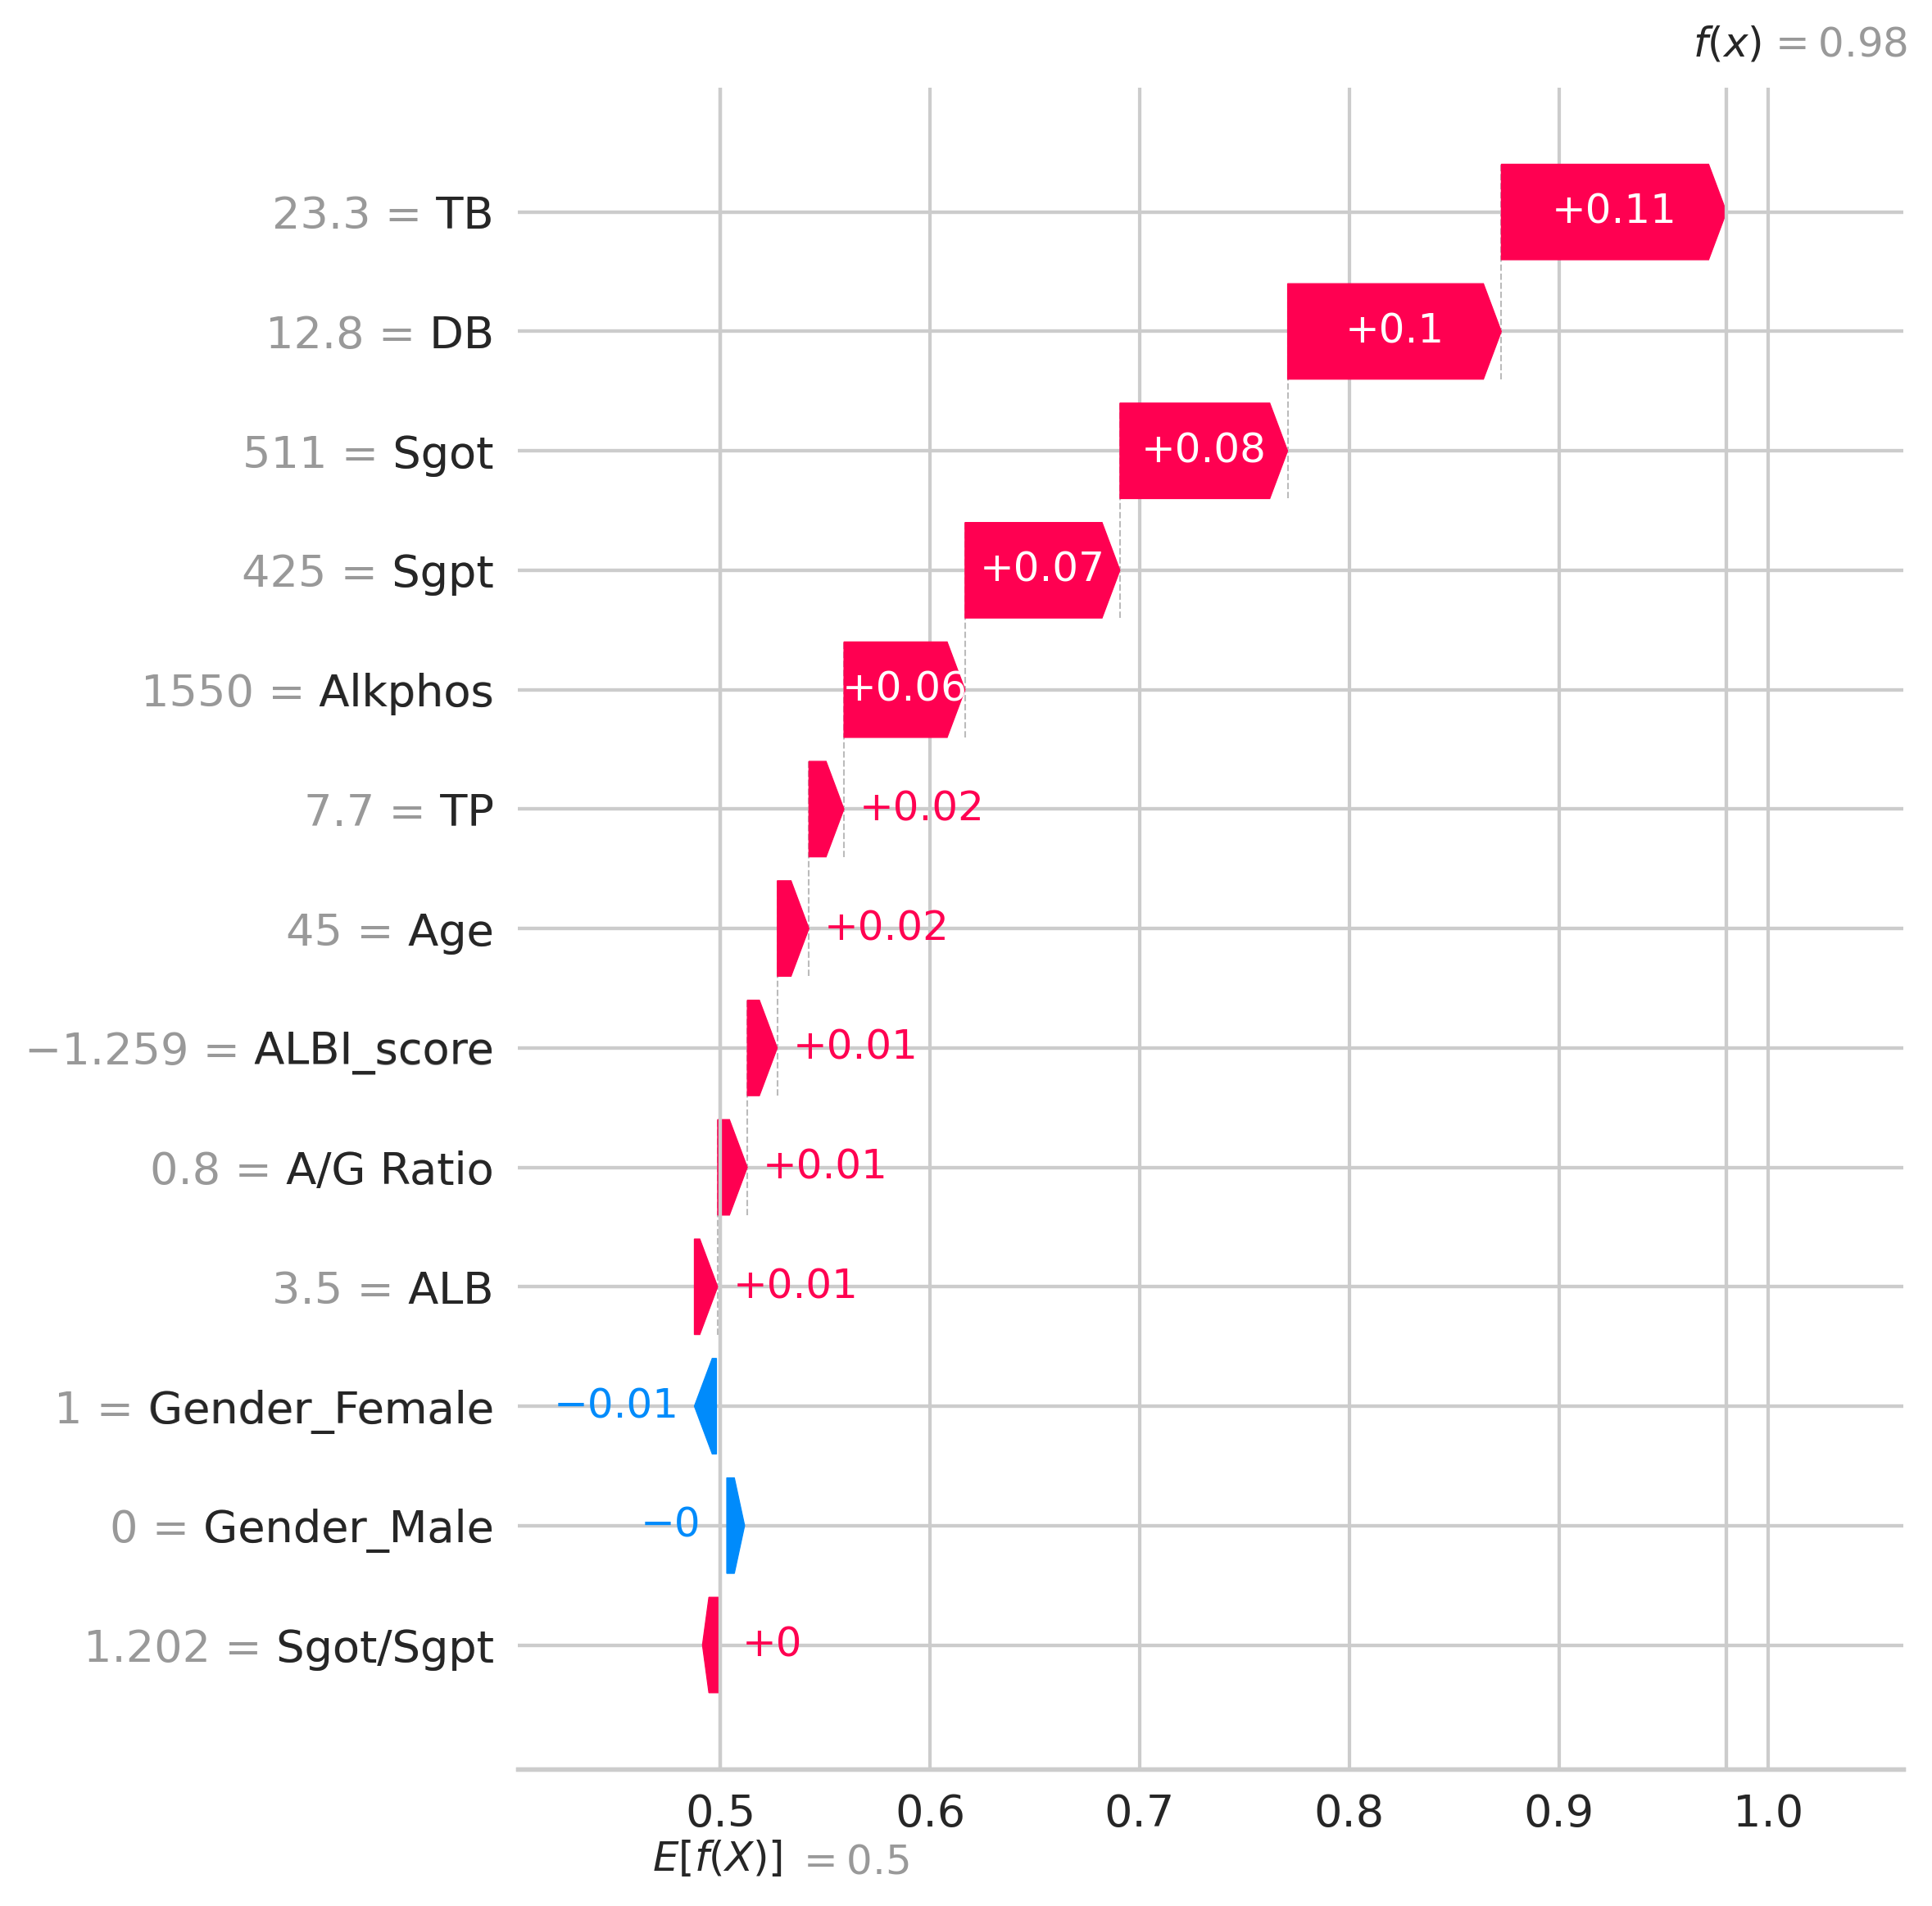
血液検査データから肝疾患を予測するモデルを構築するために、PyCaretを用いて13種類の機械学習モデルでデータ解析を行い、AUCで性能評価を行った結果、Extra Trees Classifierを選択しました。対象データでは、欠損を除いた579例中416例に肝疾患が認められ、8項目の血中物質濃度(TB, DB, Alkphos, Sgpt, Sgot, TP, ALB, A/G_ratio)と年齢、性別及び新たに作成した2つの特徴量であるSgot/Sgpt比、ALBIスコアの合計12の説明変数を用いて、肝疾患の有無を予測するホールドアウト(約20%)を行った結果、ROC-AUC : 0.79, Accuracy : 0.72, Recall : 0.94, F1 : 0.83でした。ハイパーパラメータのチューニングをOptunaを用いて行いましたが、性能の改善は認められませんでした。各特徴量の予測性能への影響度をSHAPで調べたところ、TBが最も大きく、DB、年齢、Alkphosと続きました。SHAPのbeeswarm, dependence plot, waterfall plotのグラフから、各特徴量の予測性能への重要度、方向性、分布、閾値ゾーンなどが示されました。
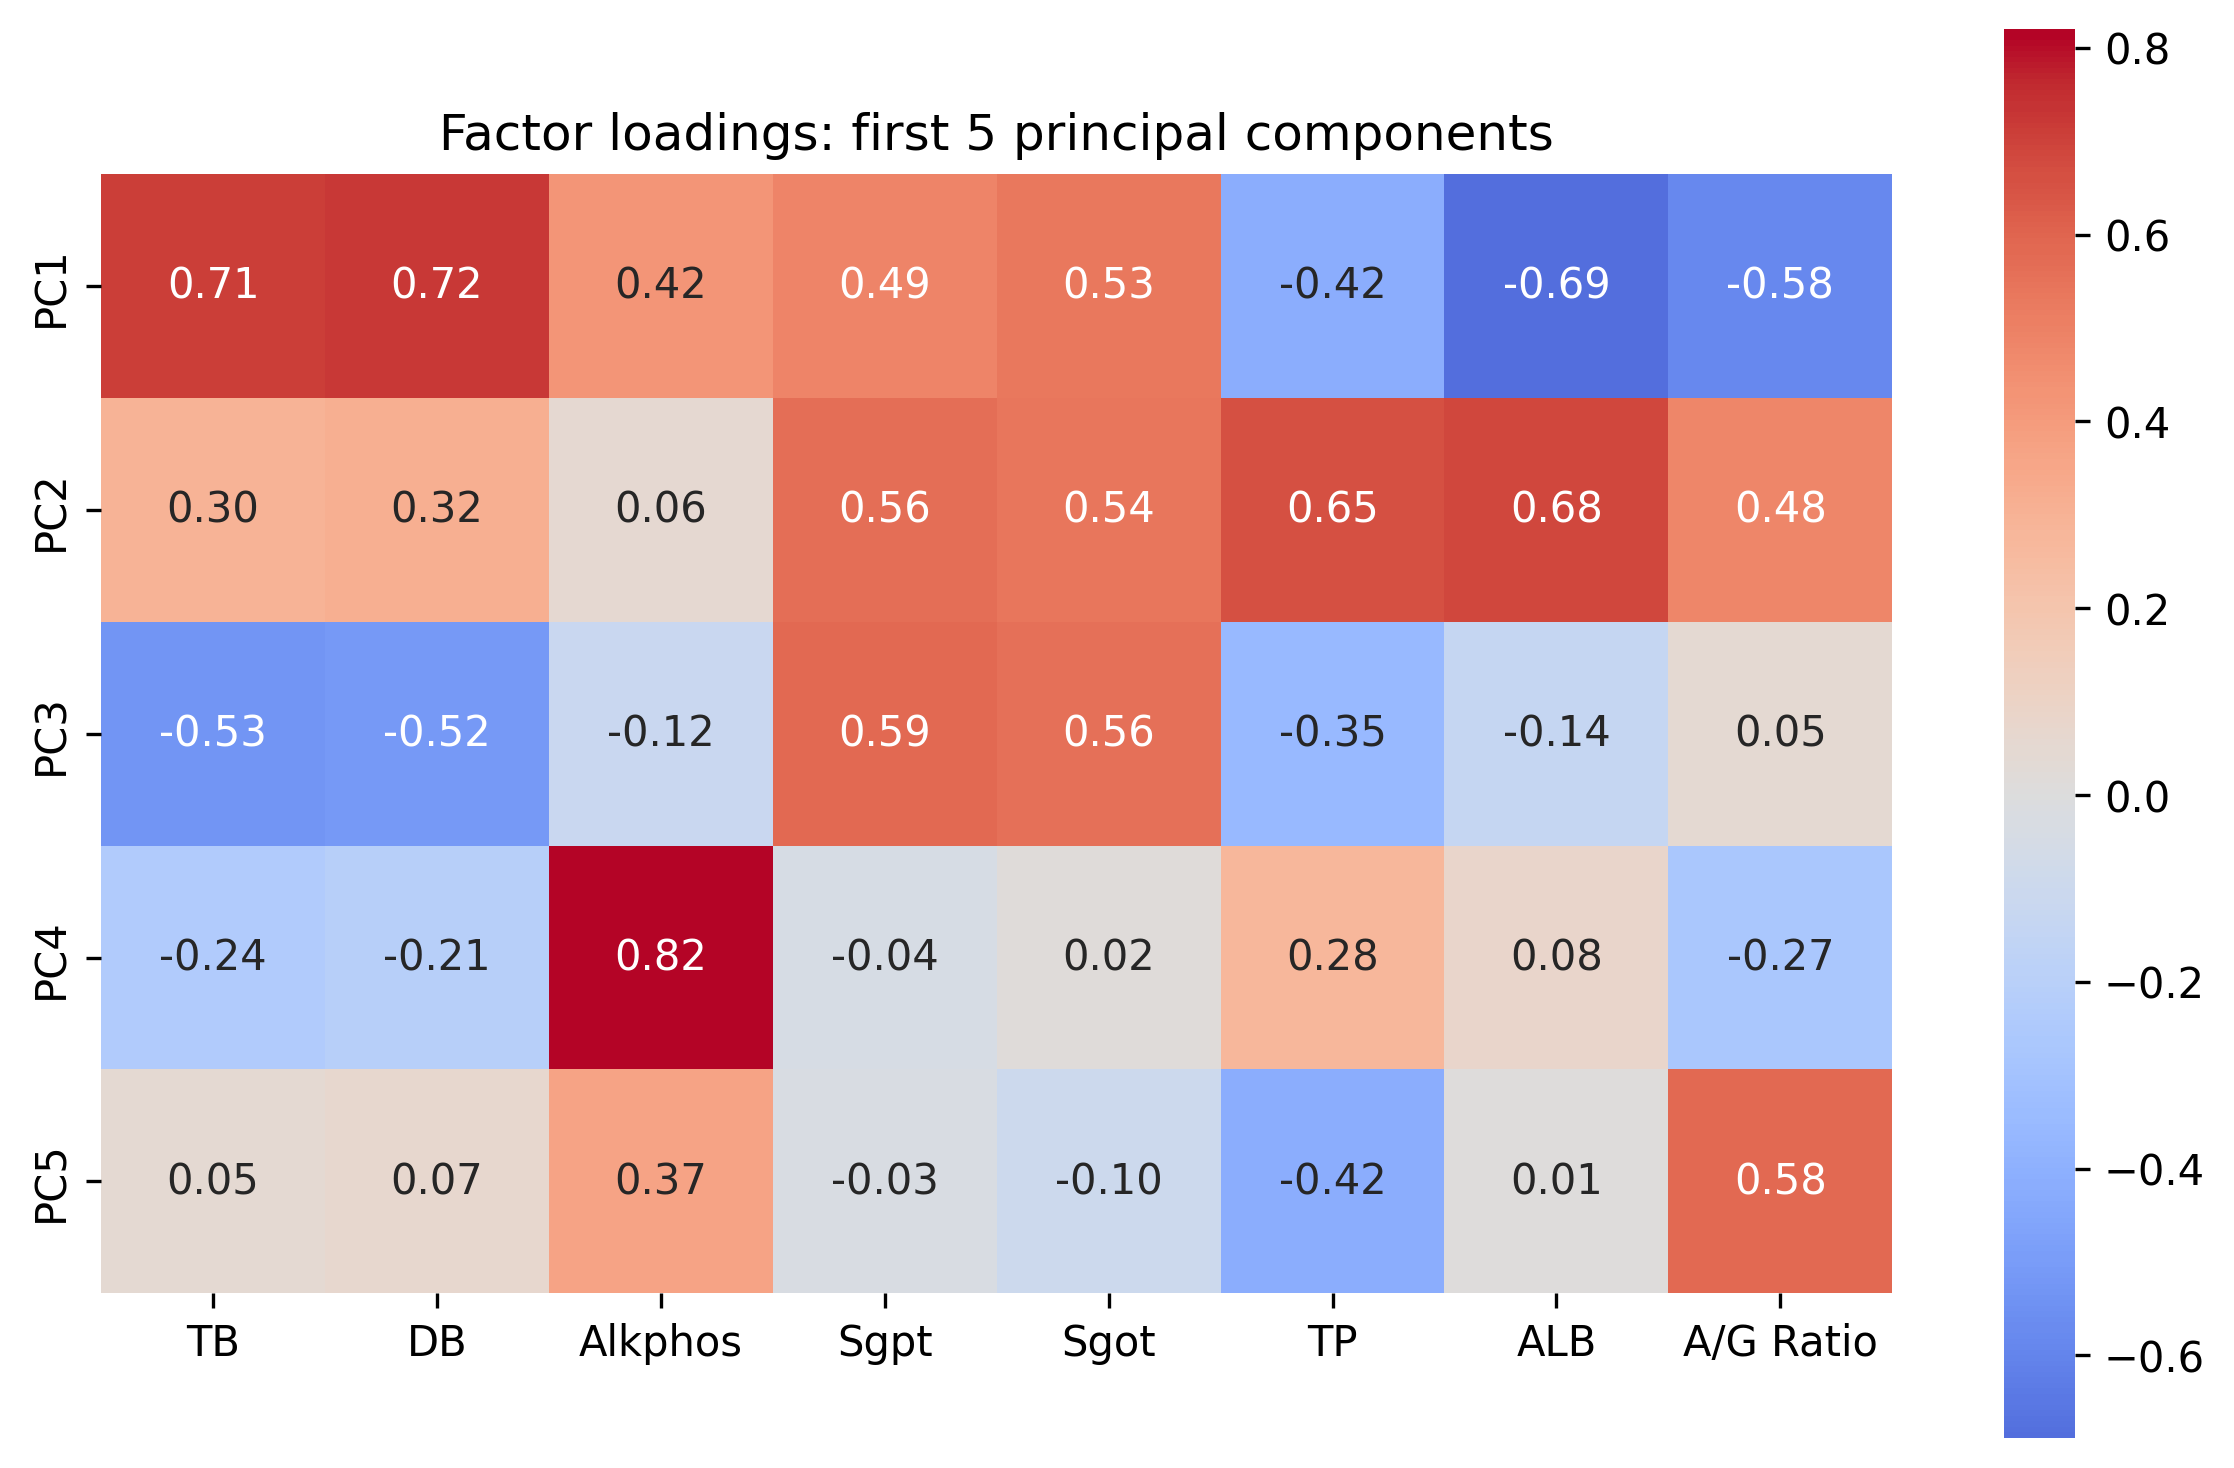
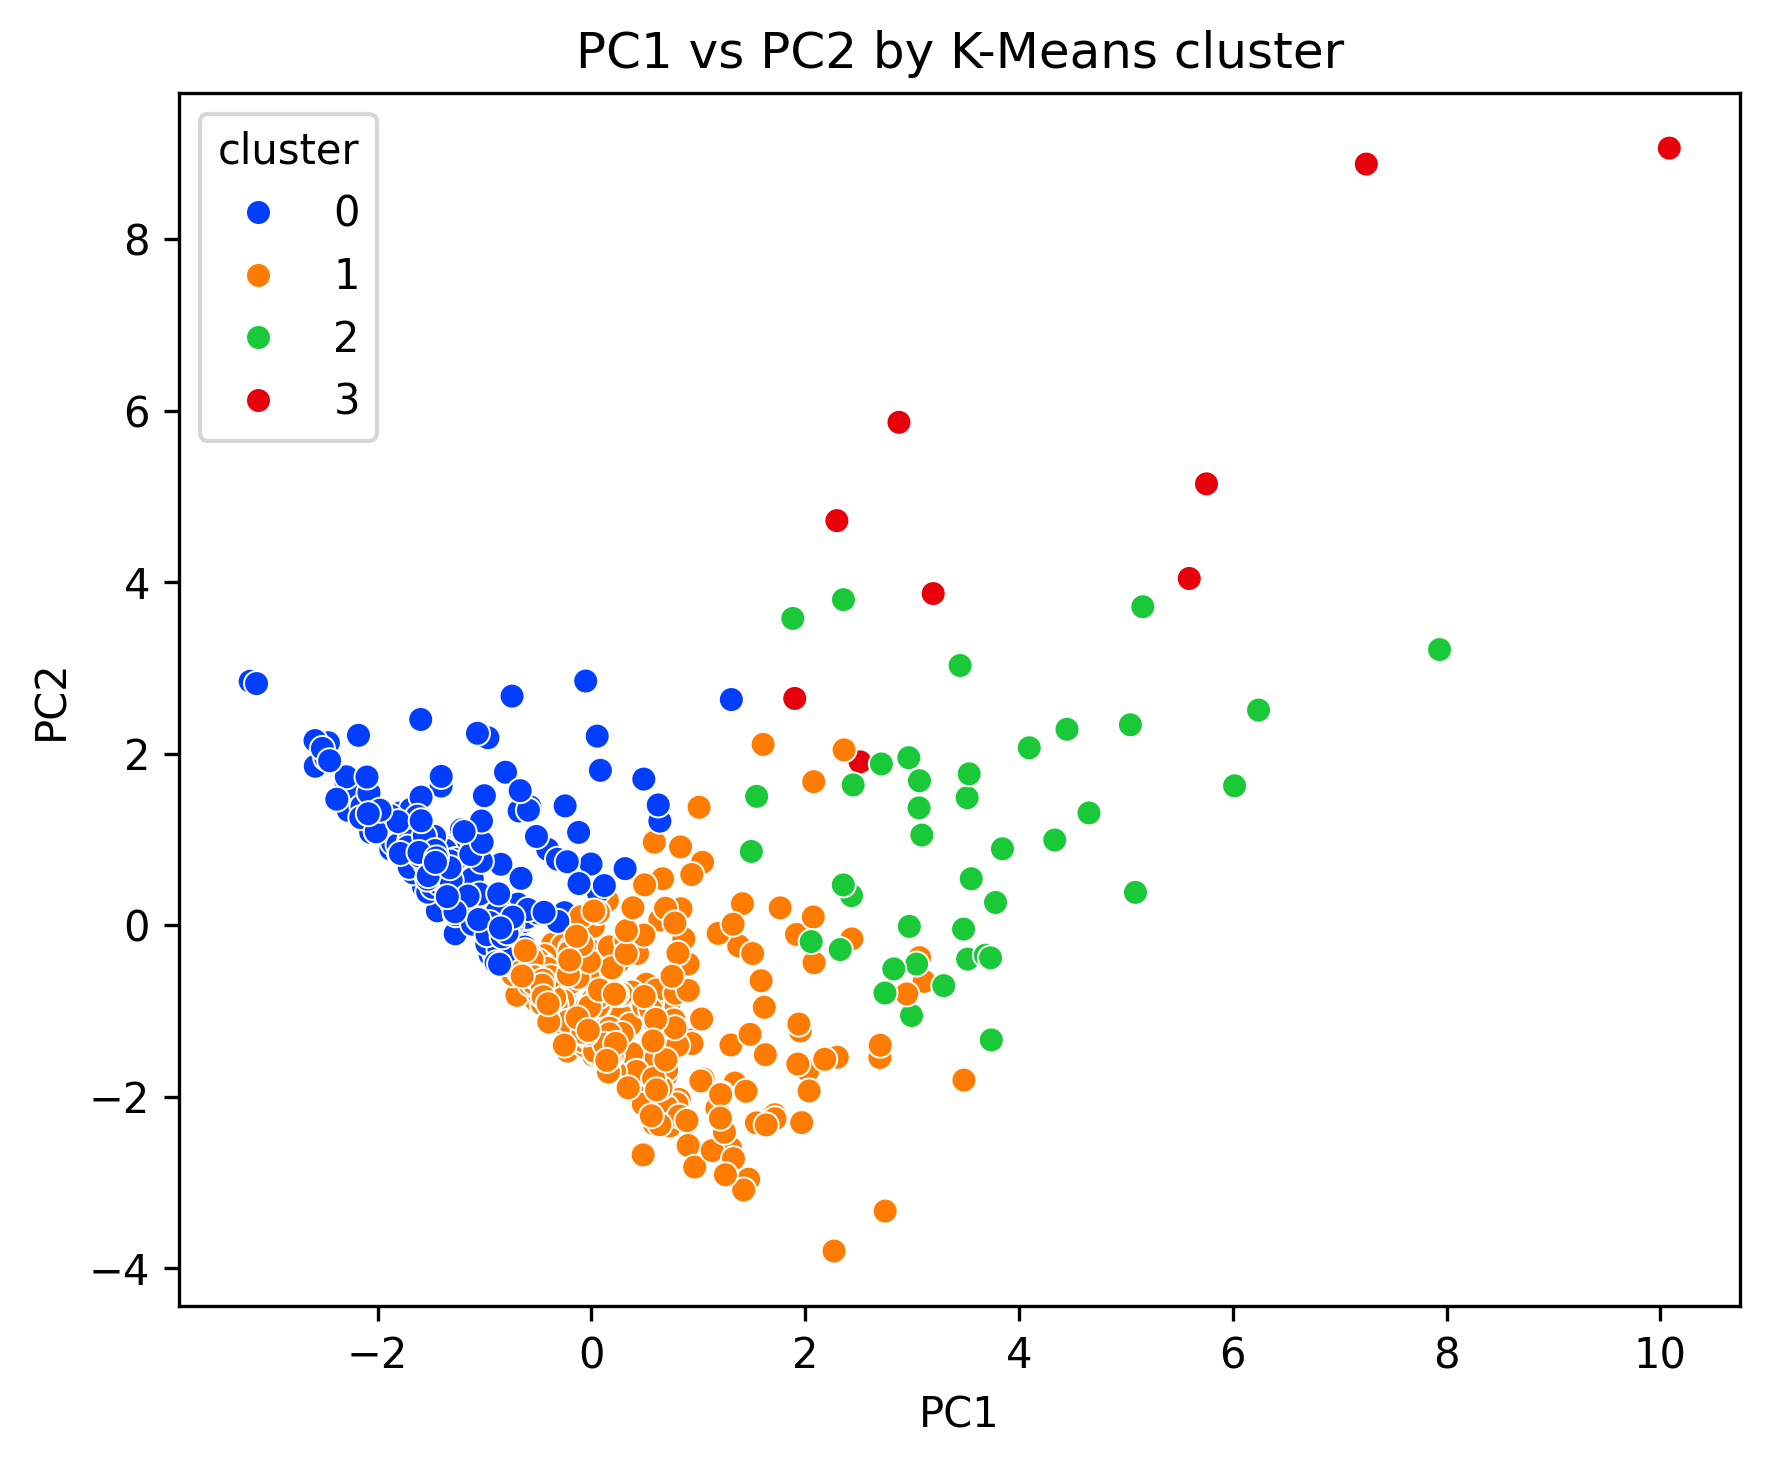
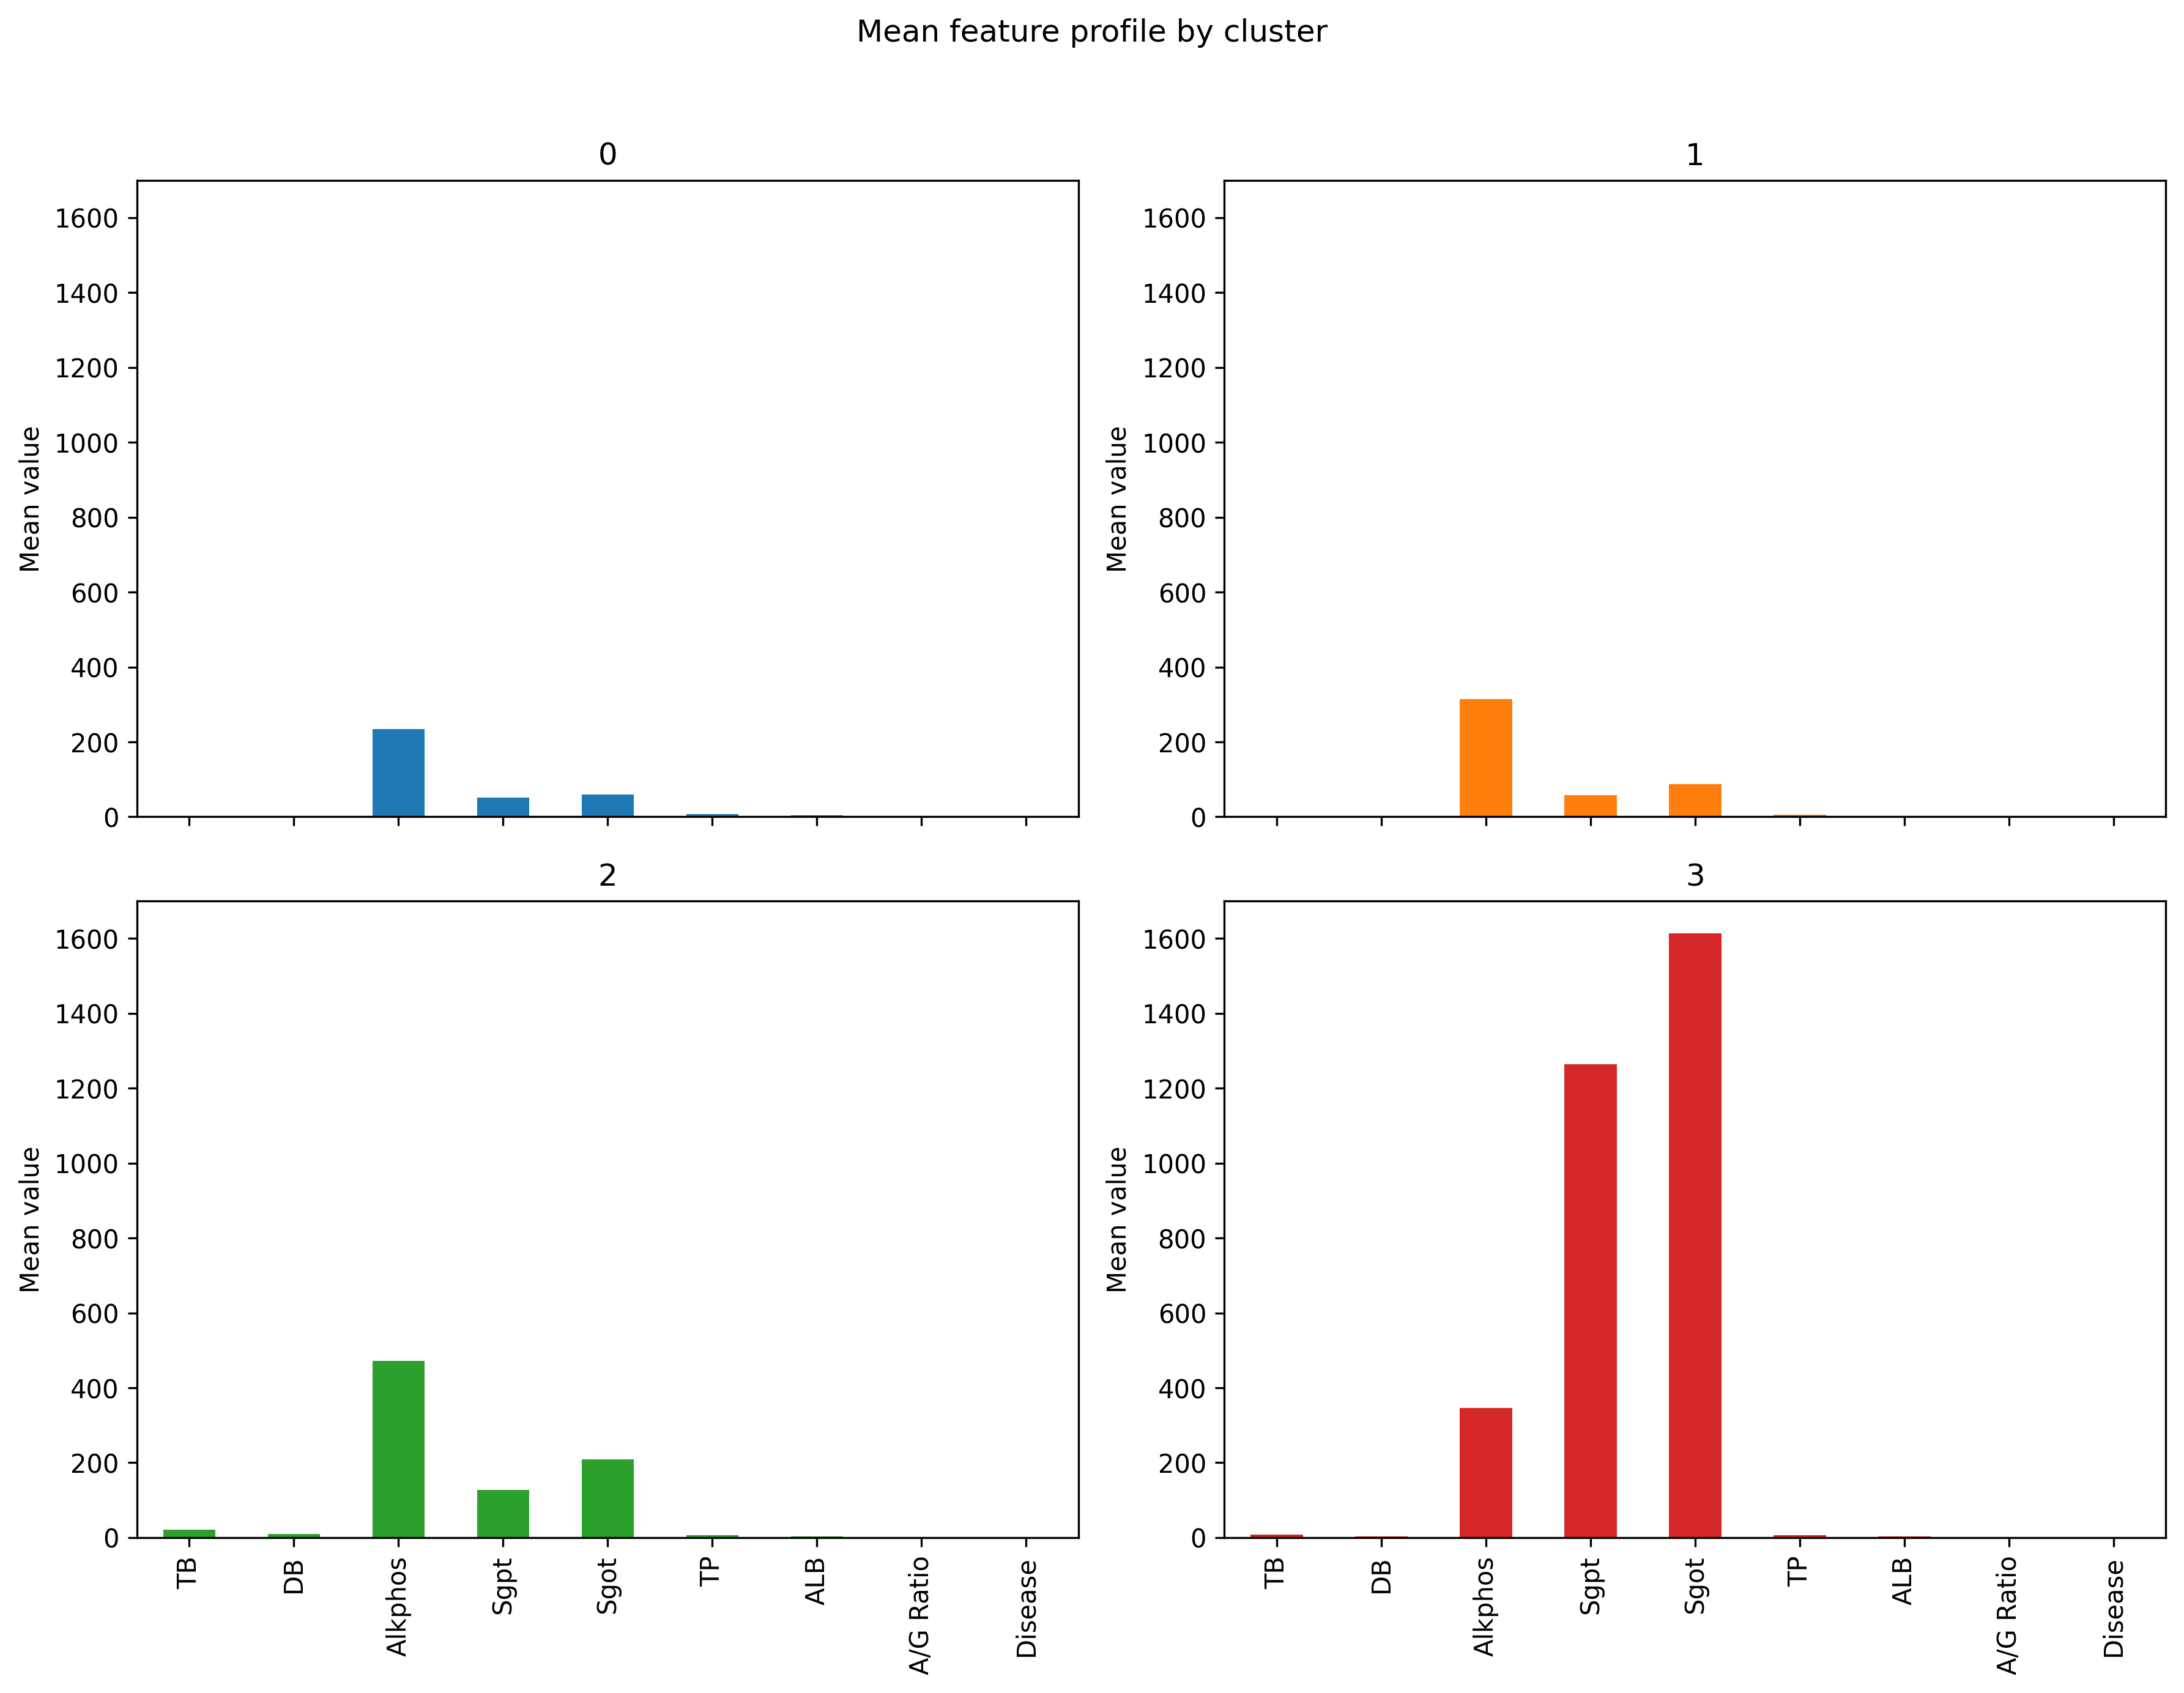
患者の病態分類のために、上記8項目の血中物質濃度を標準化したうえで教師なし学習として主成分分析およびK-Means法によるクラスタリングを行いました。4つのクラスタごとの各特徴量の平均値や影響度の大きいTB、DBのヒストグラムから各クラスタ特有のパターンが示されました。主成分分析のPC1-PC2の二次元平面でのクラスタ別の散布図から軽症群、中等度異常群、重症群、少数の特異な重症群を区別できる可能性があります。
PyCaret · Extra Trees · Optuna · PCA · K-Means clustering · SHAP
Complex Survey Analysis
NHANES 2021–2023公開データを用いた肝線維化スコア関連因子の解析
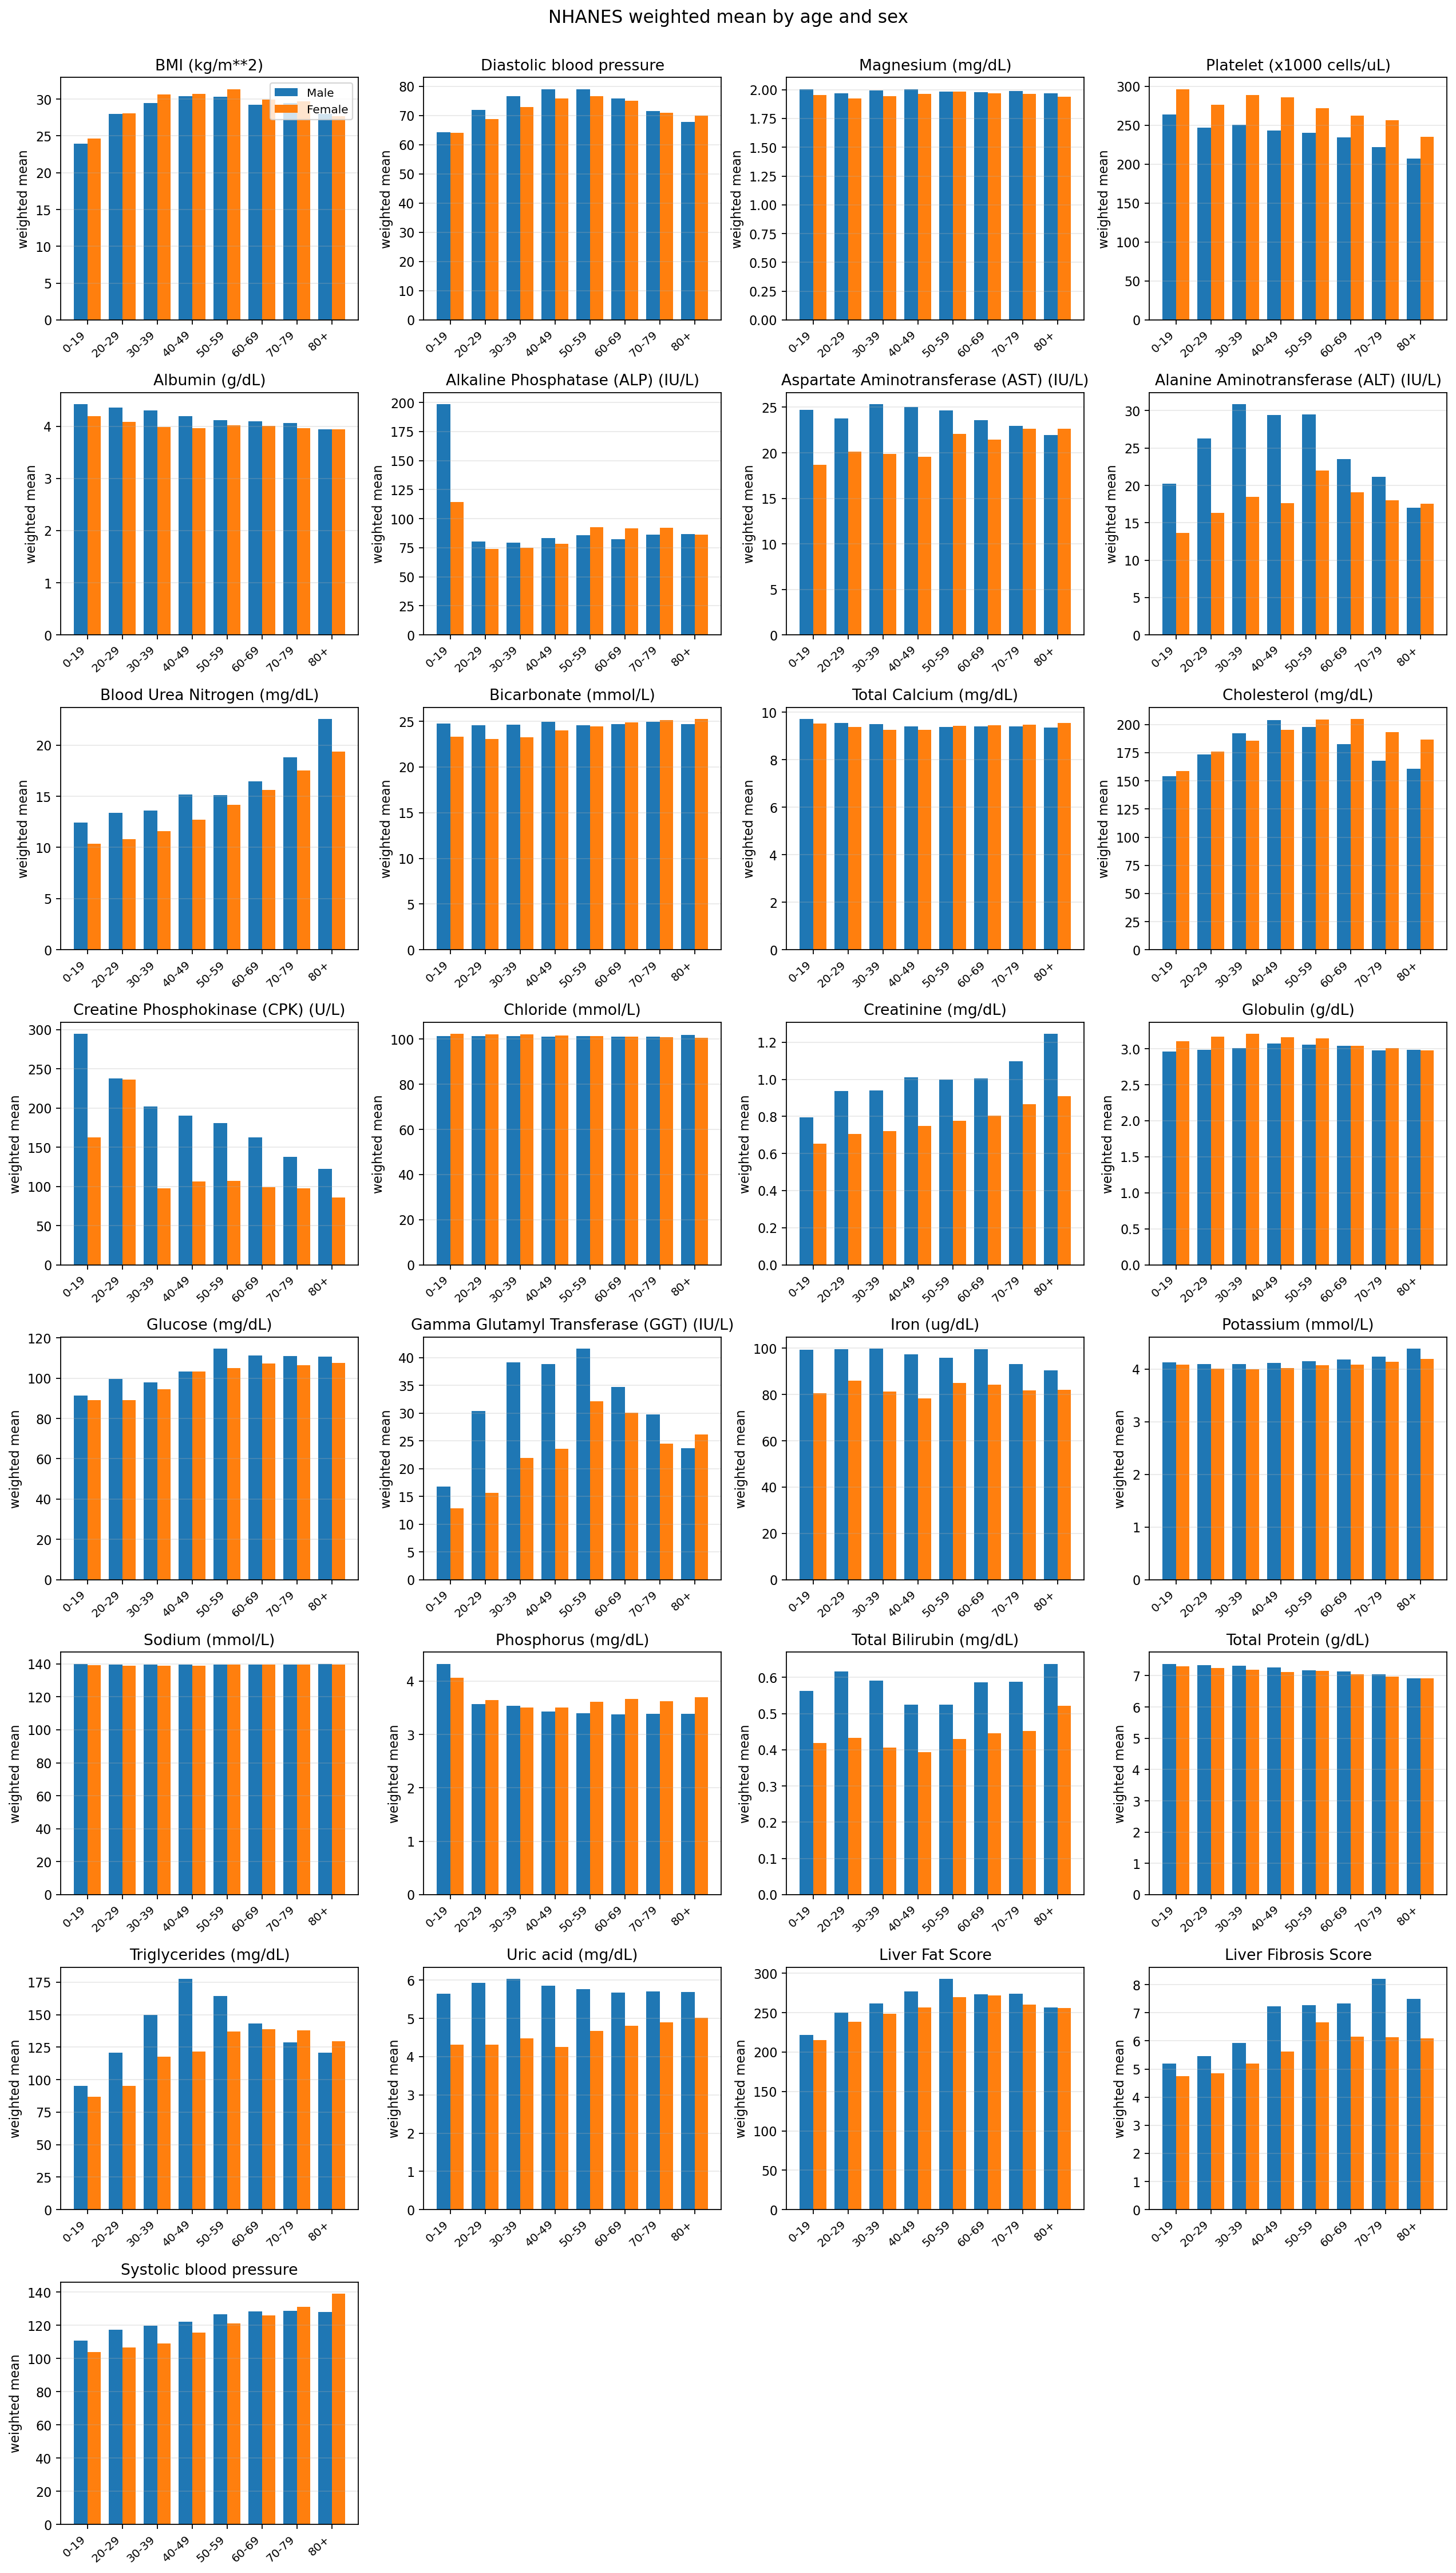
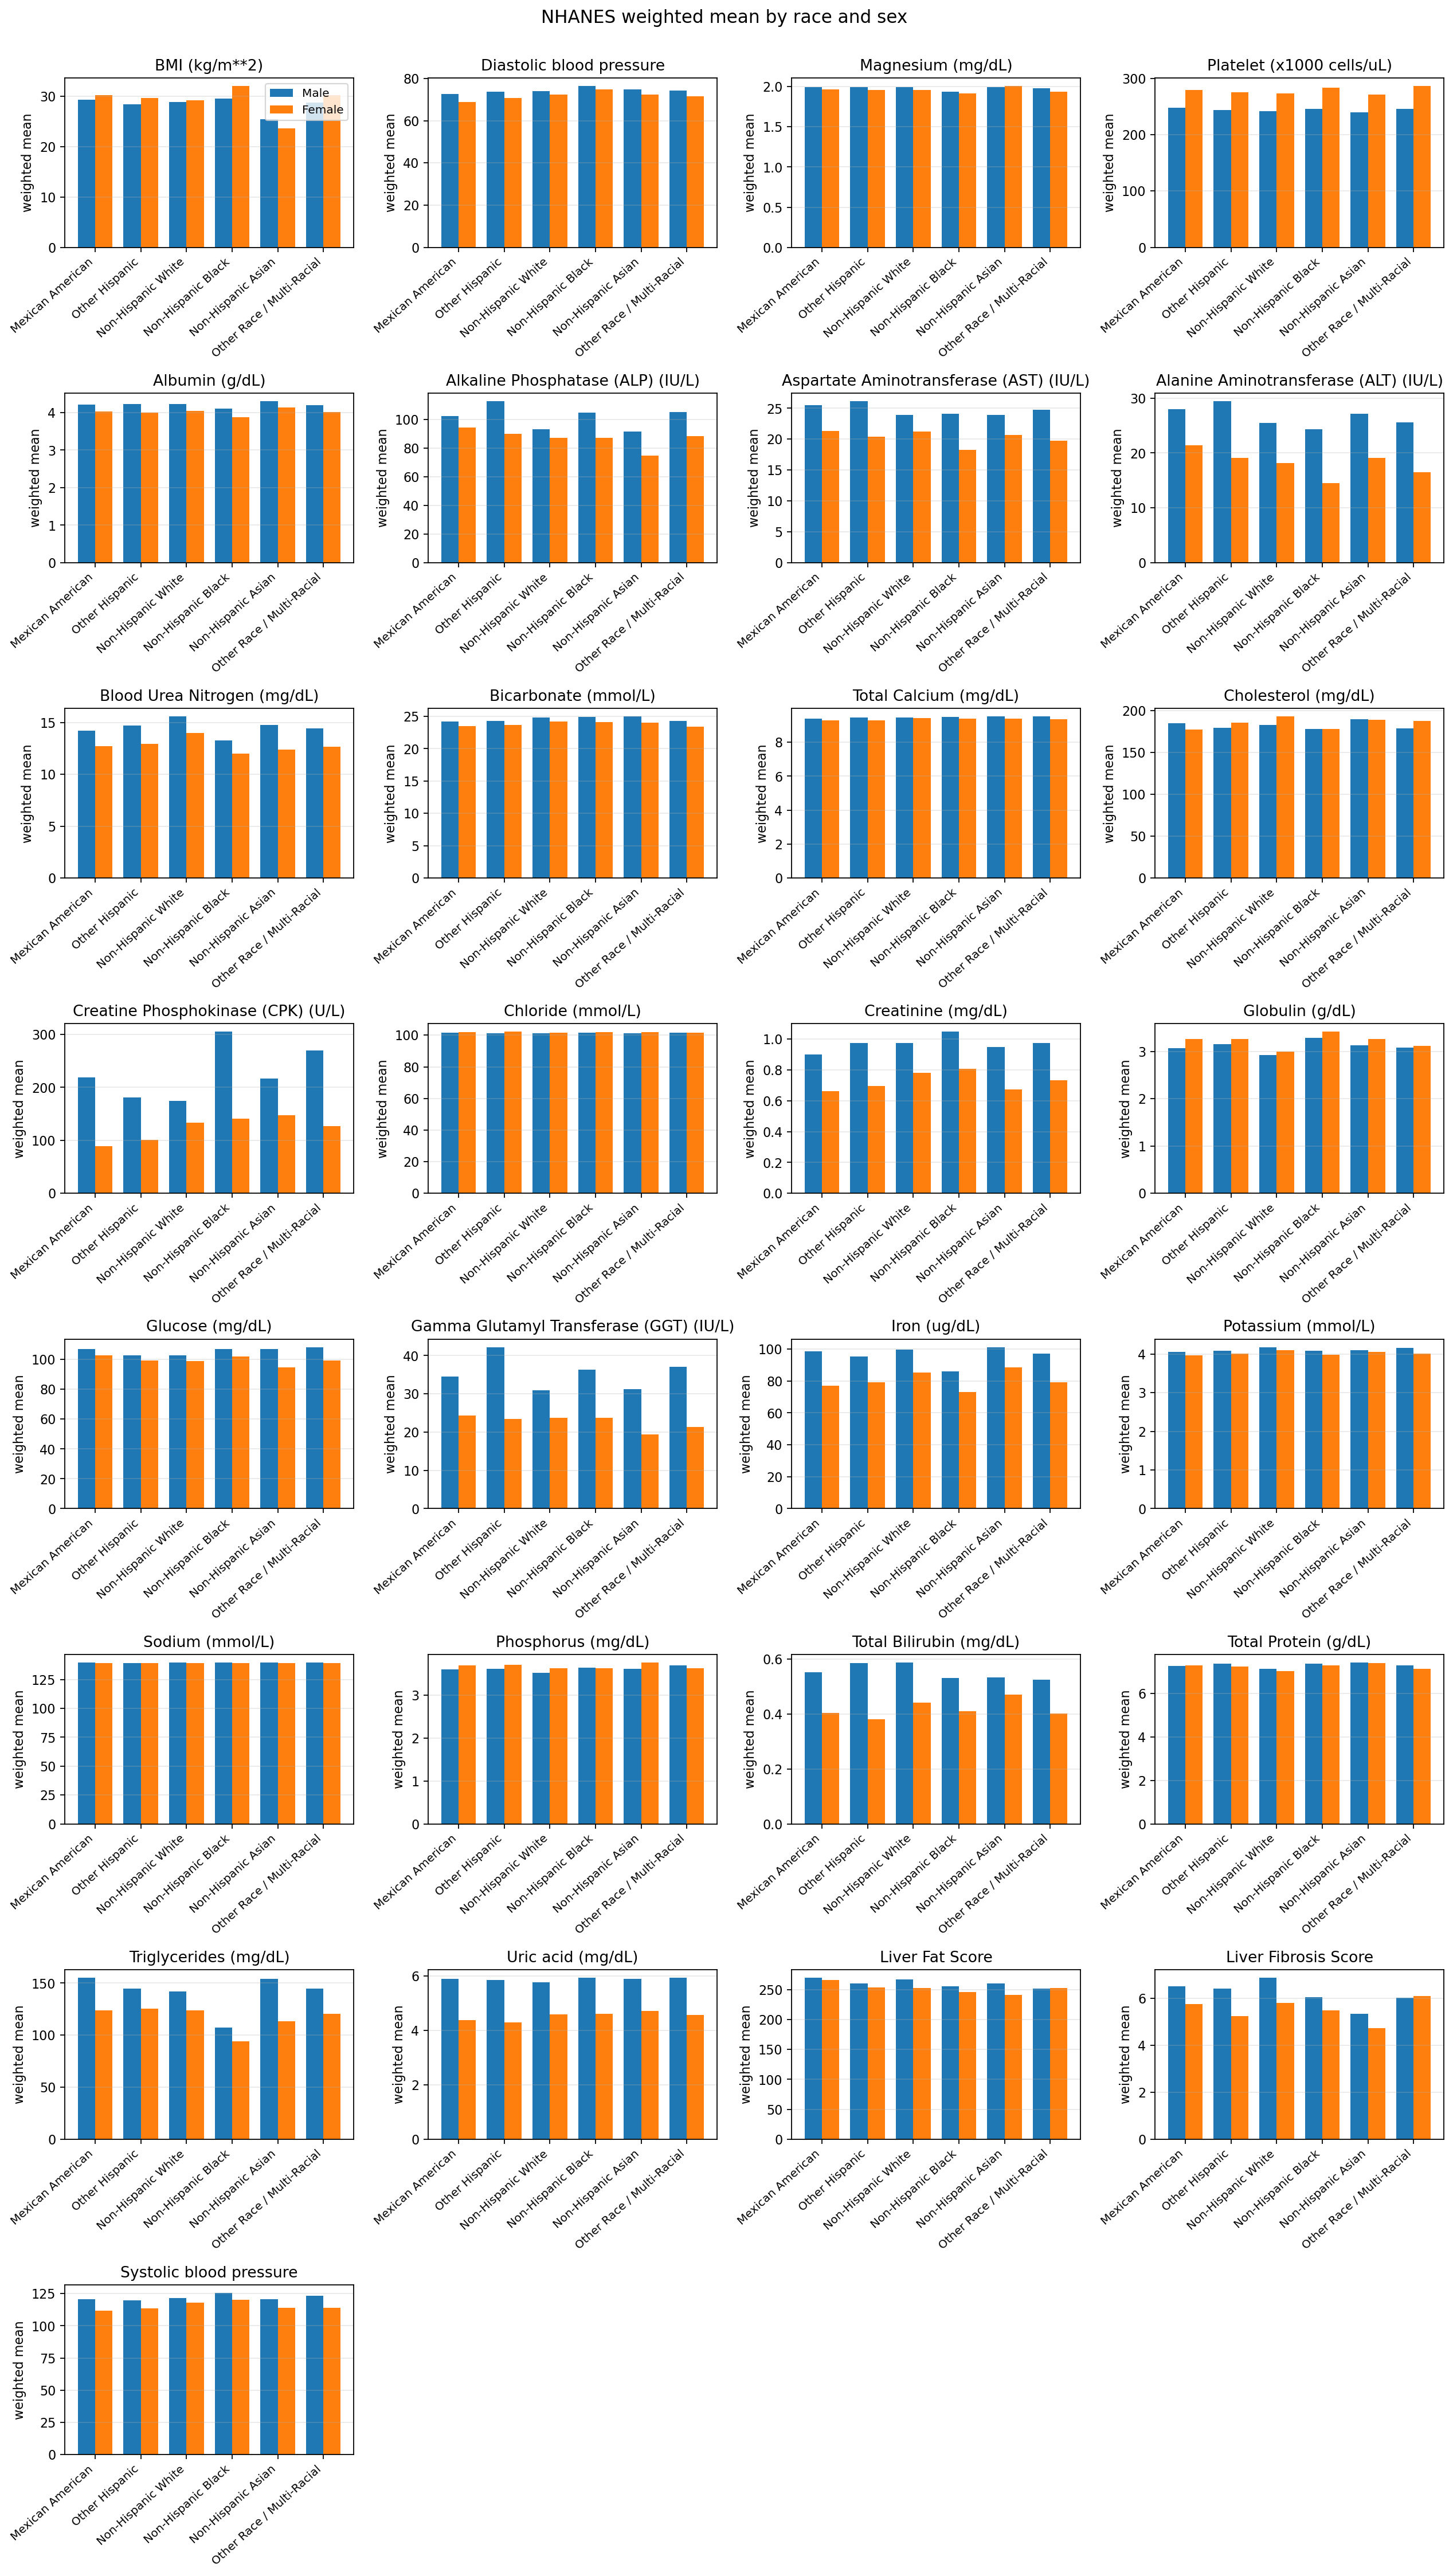
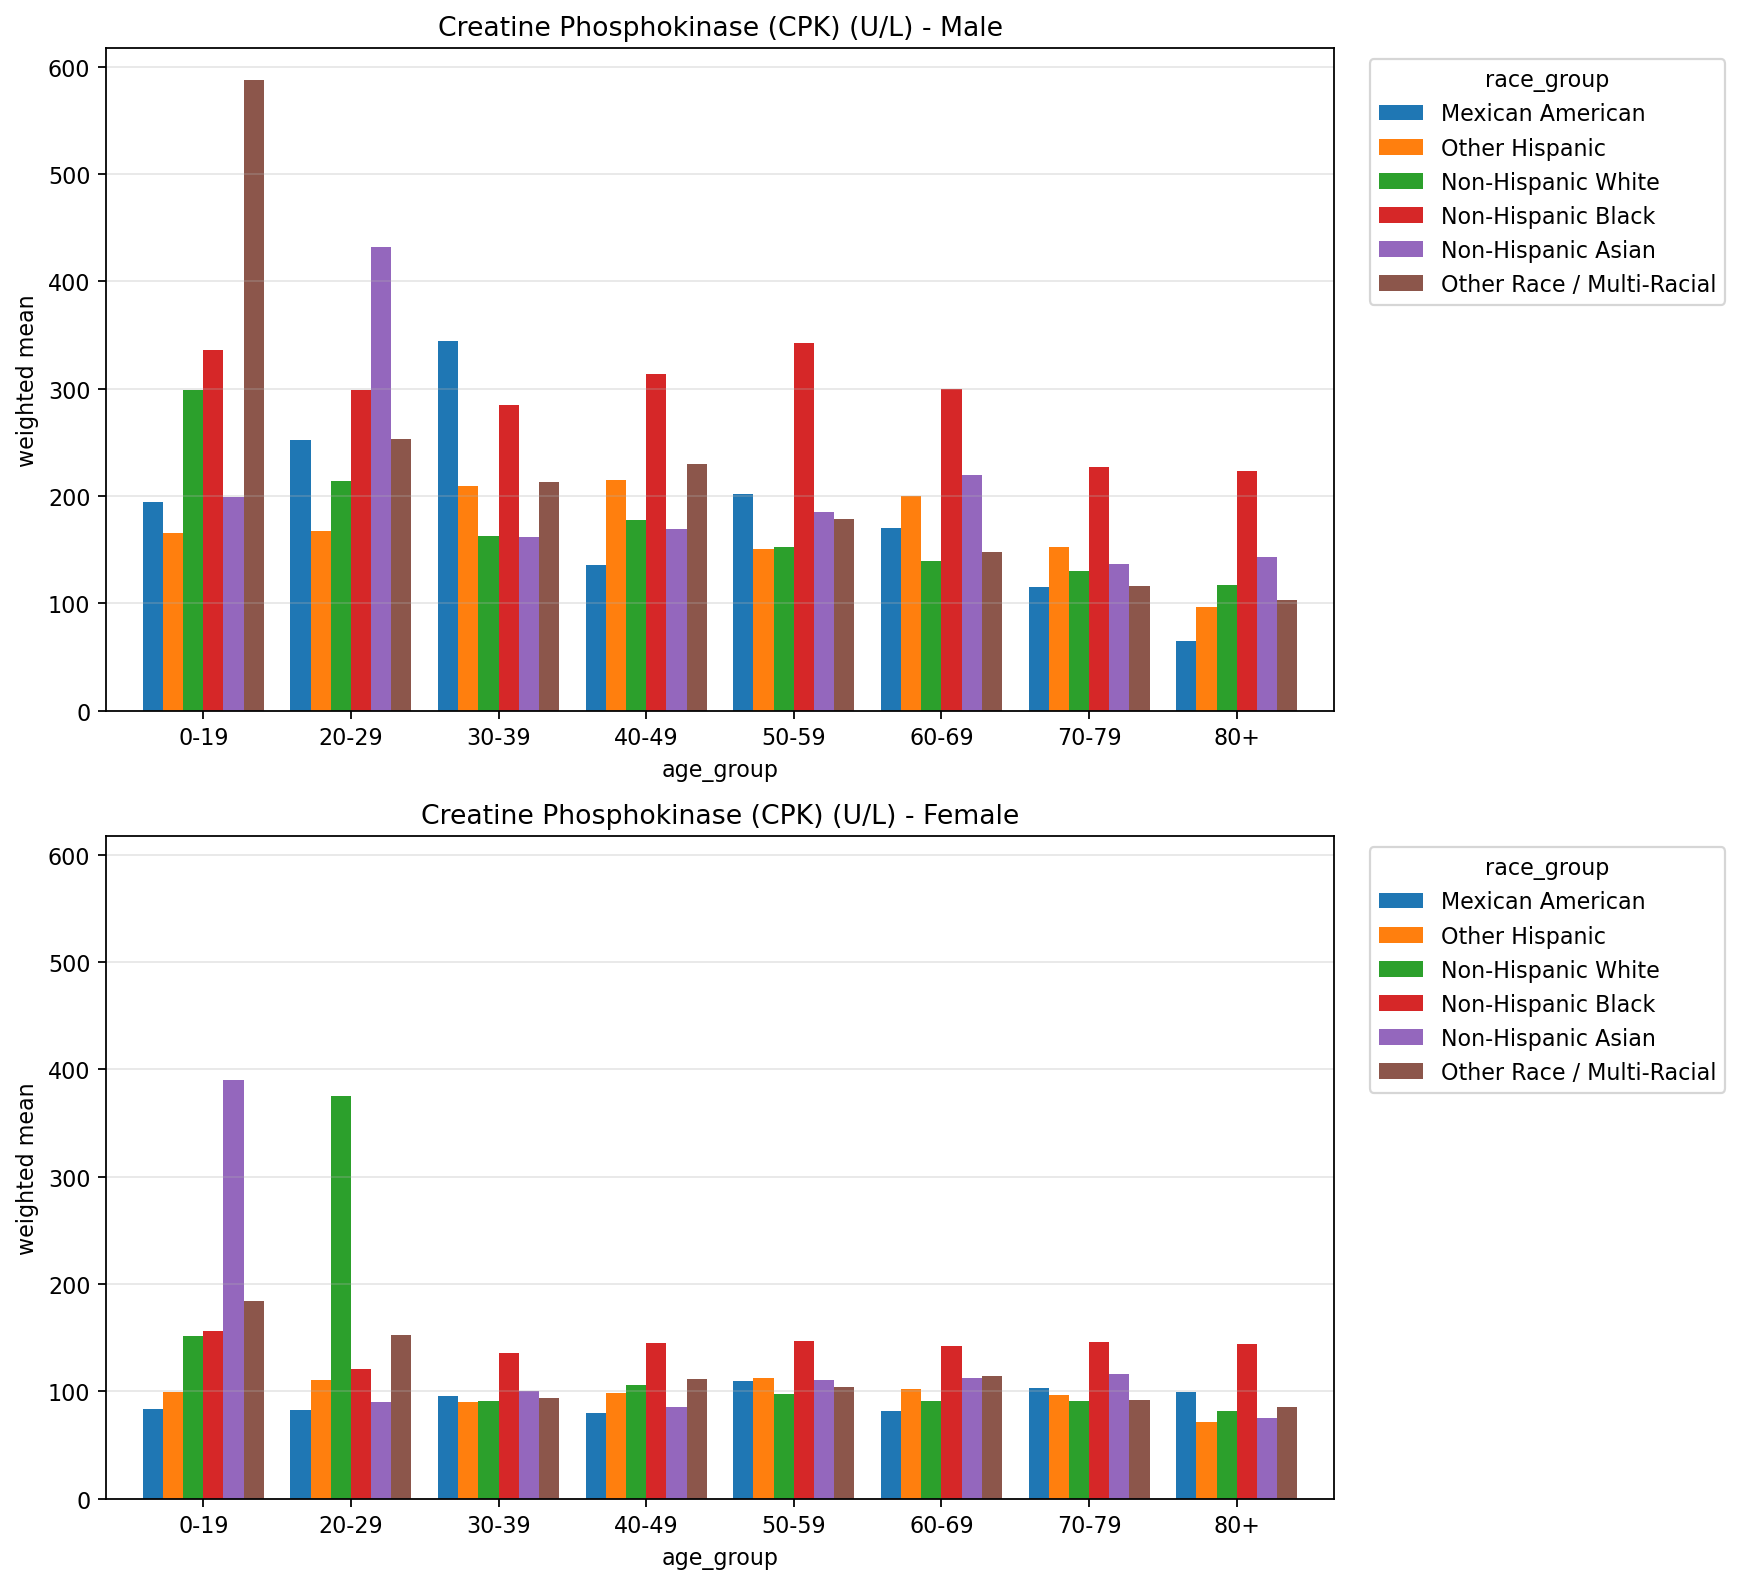
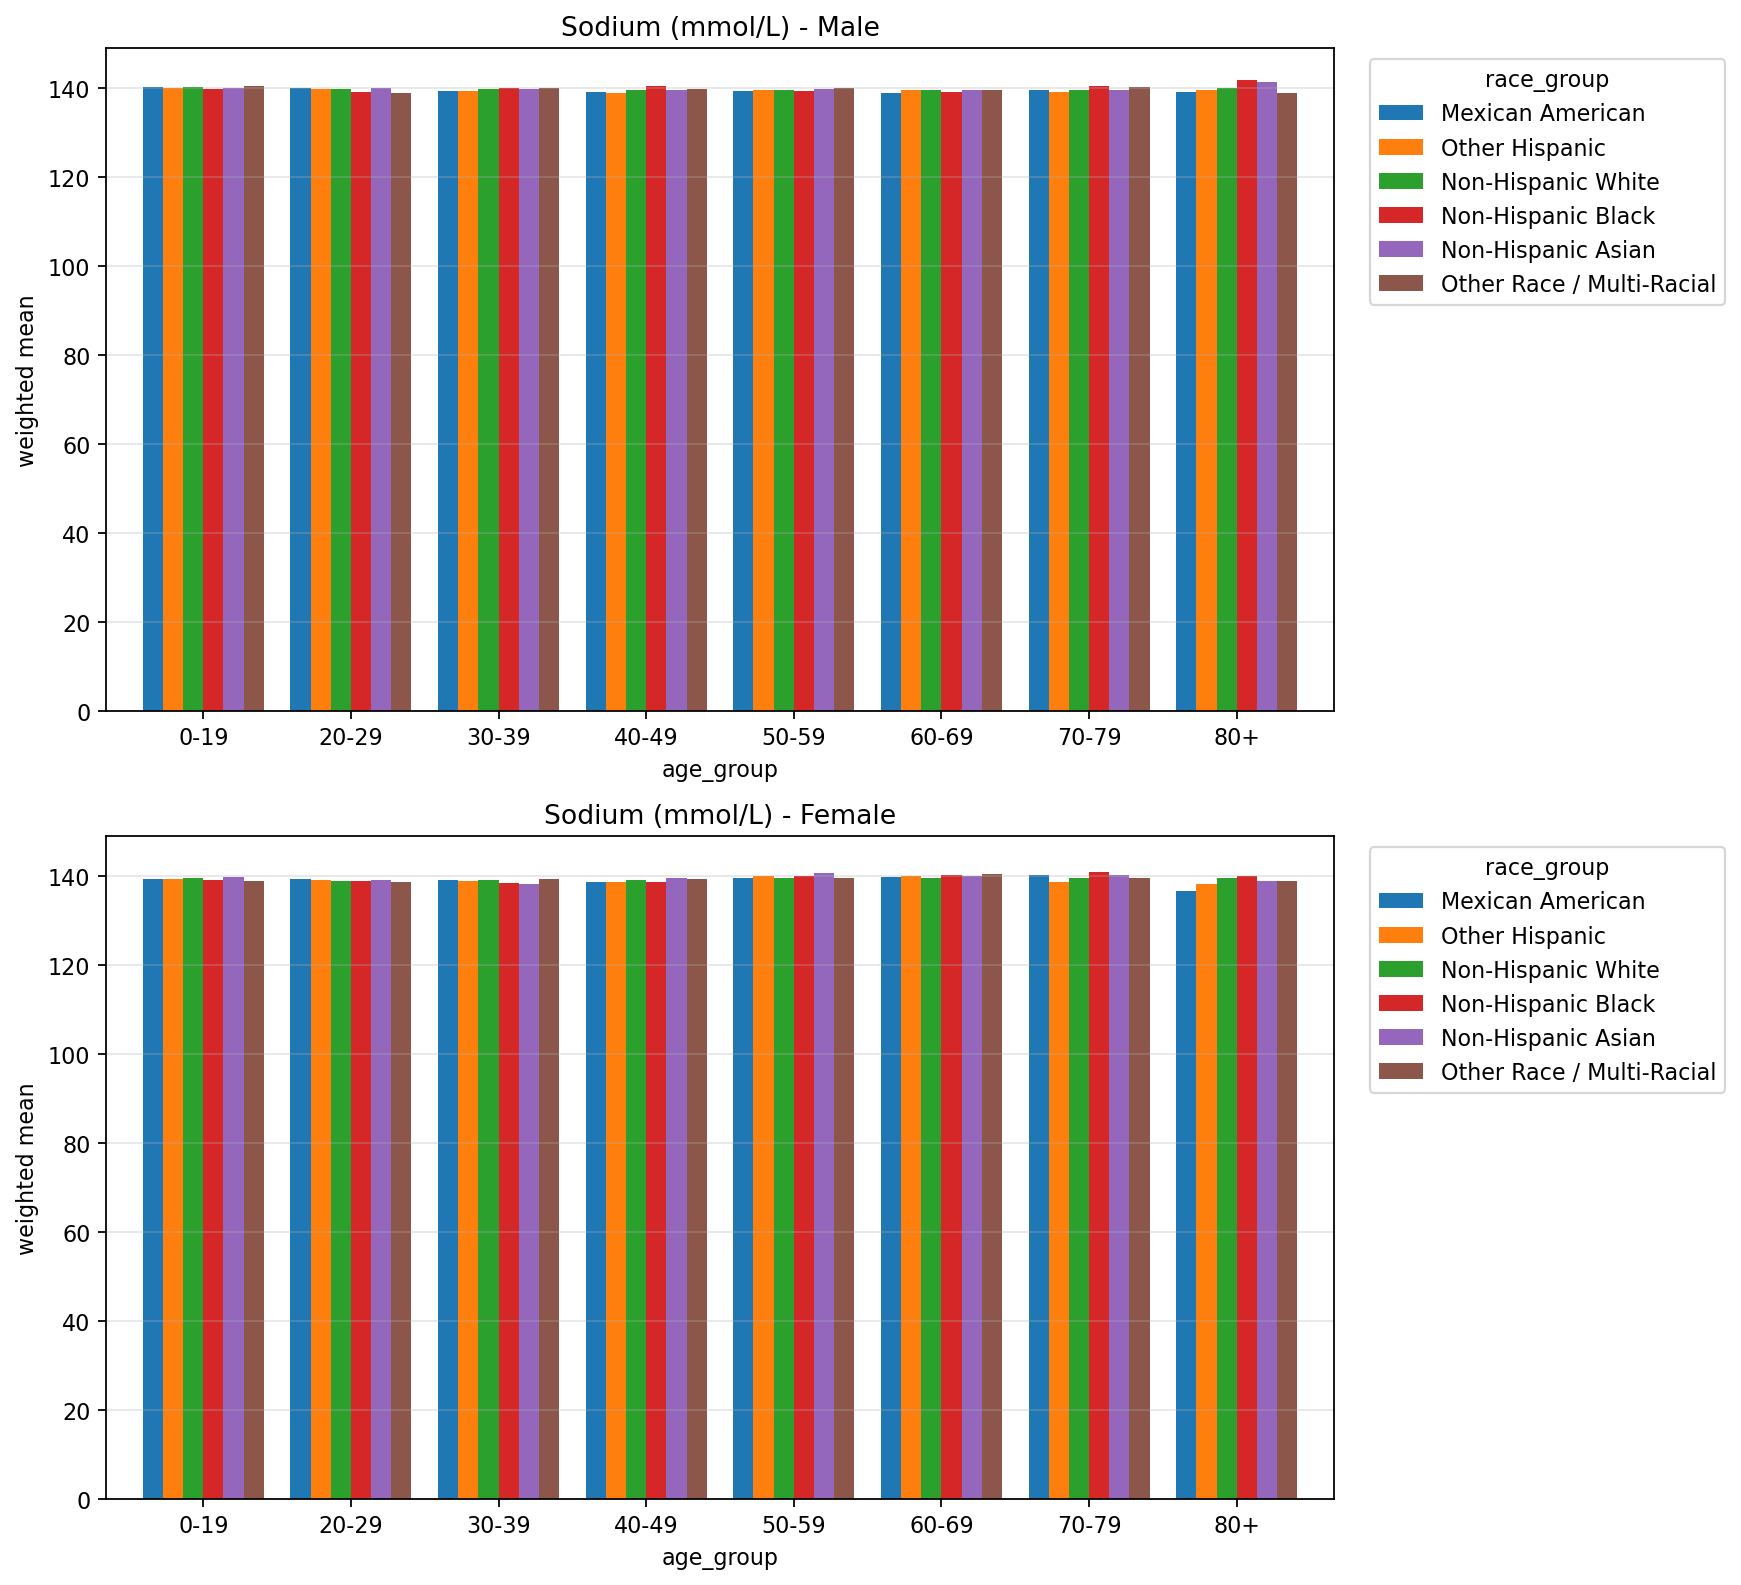
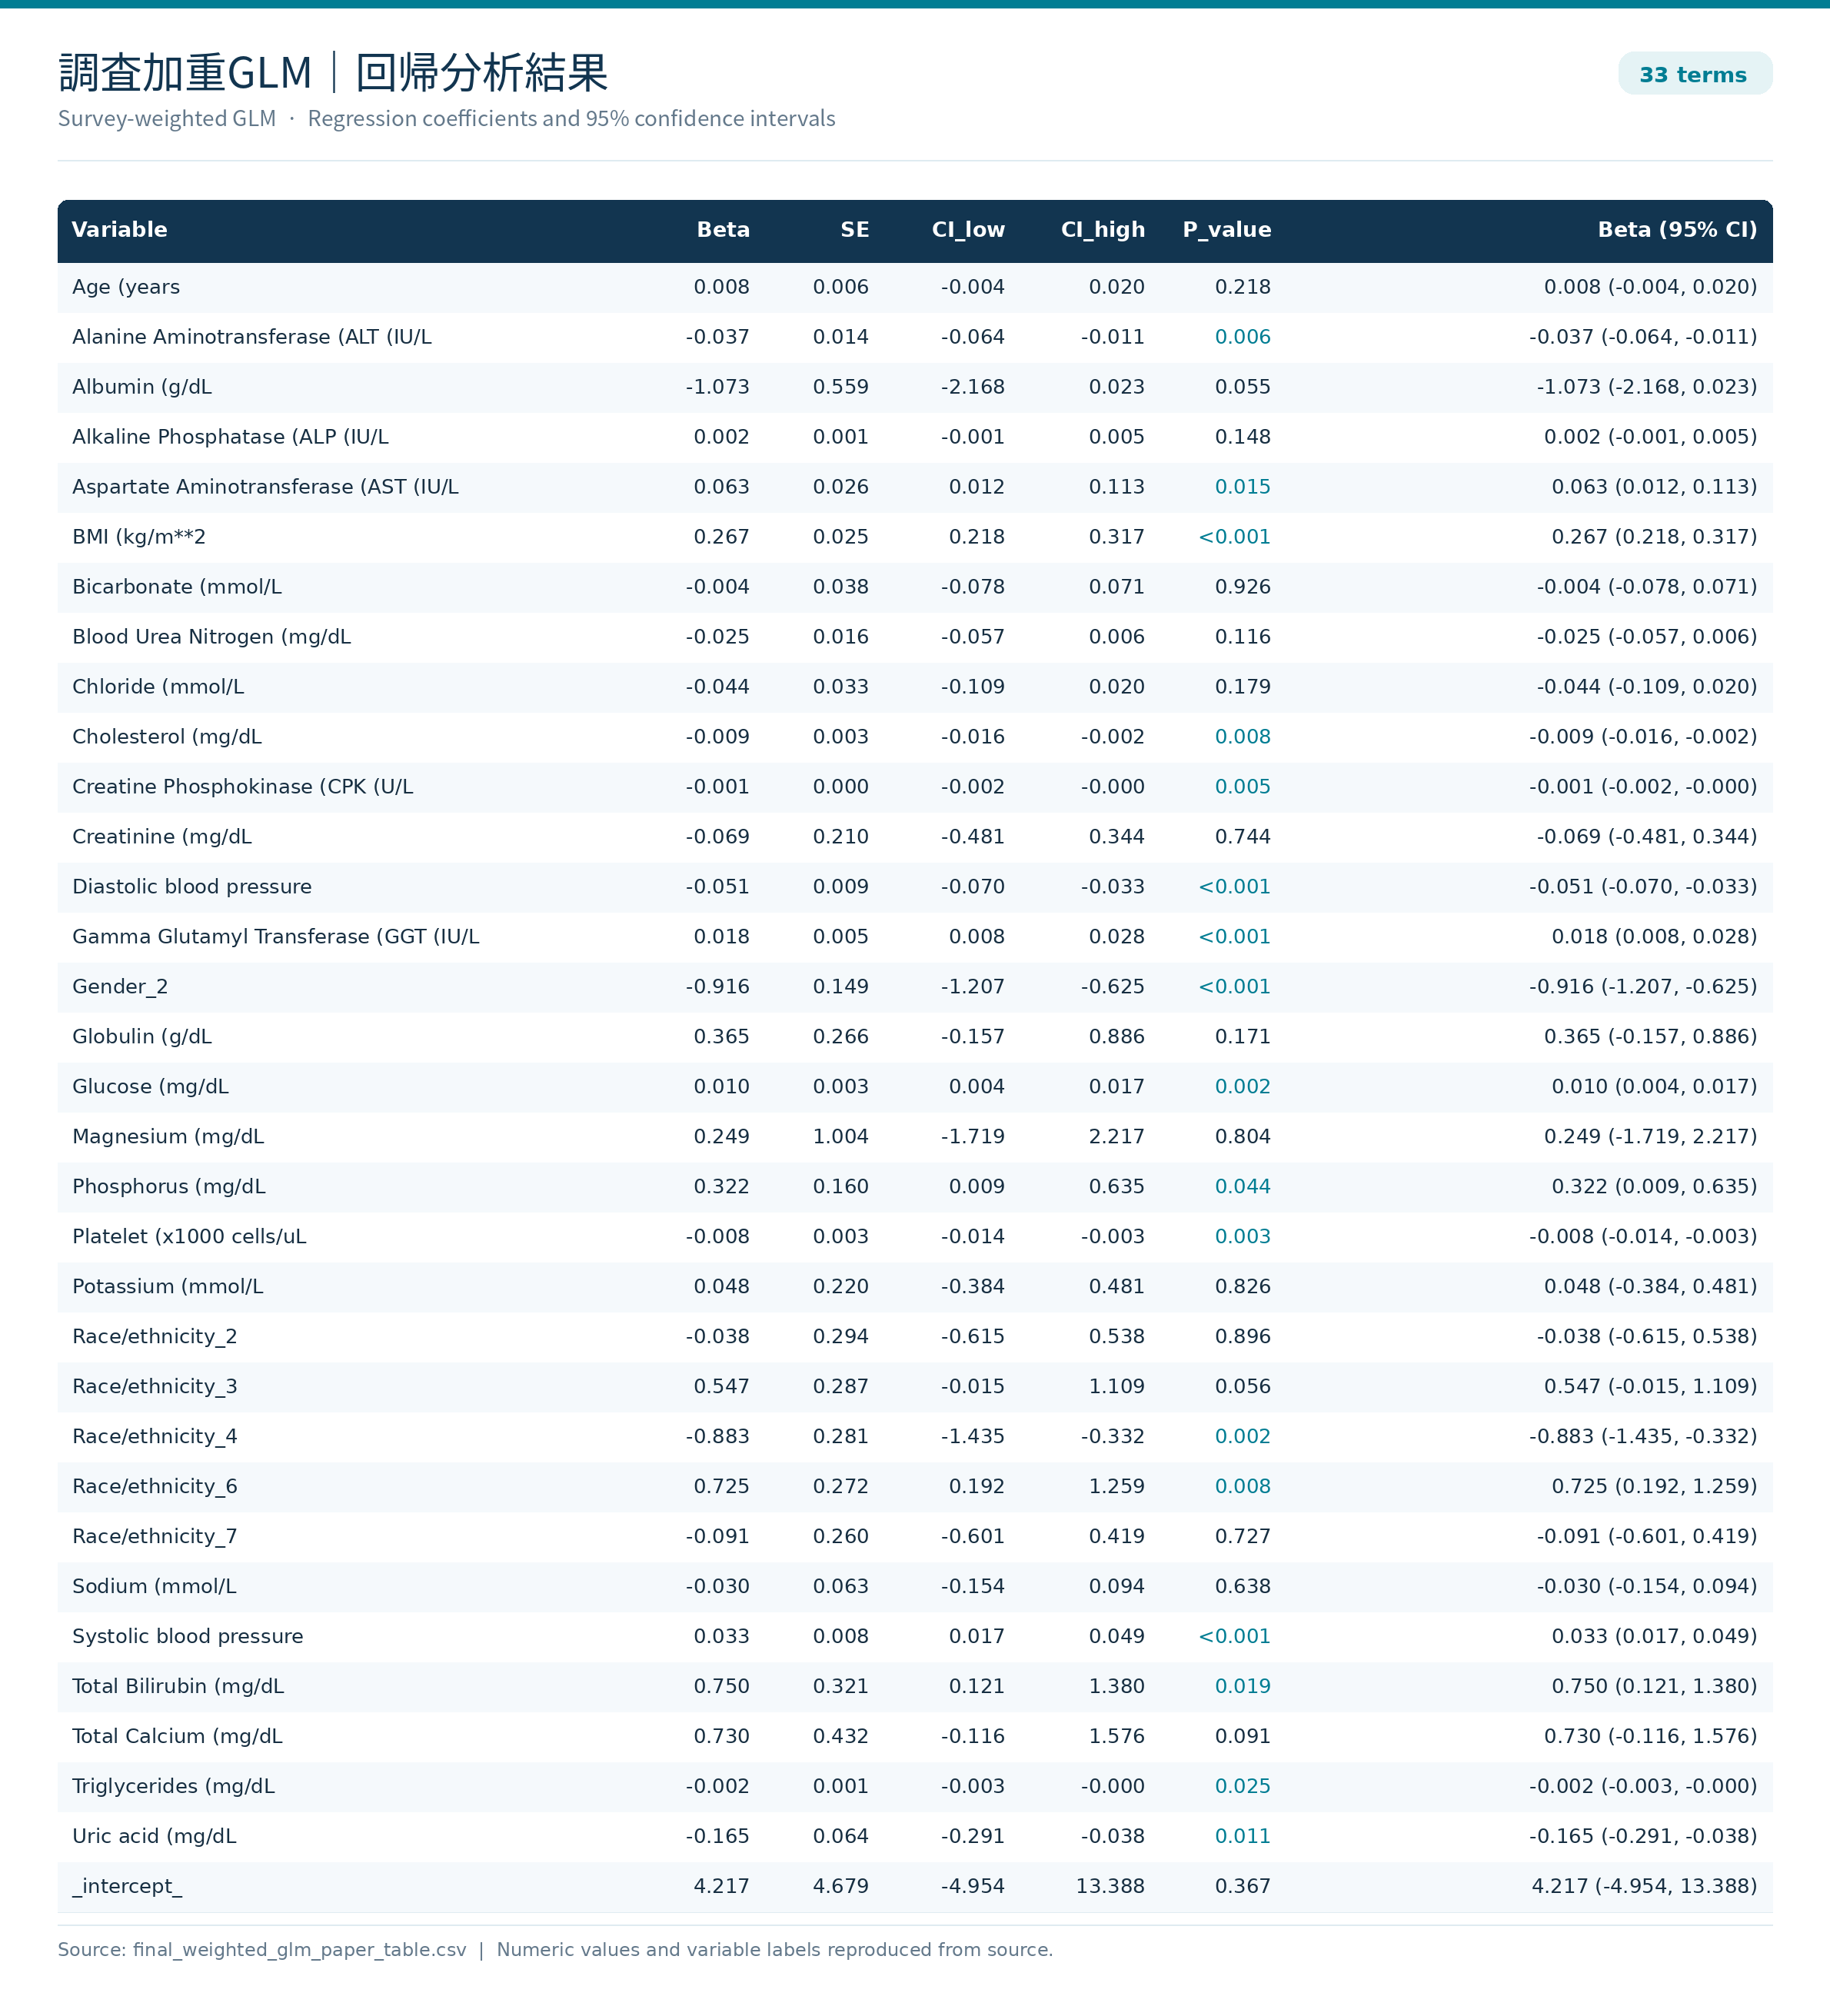
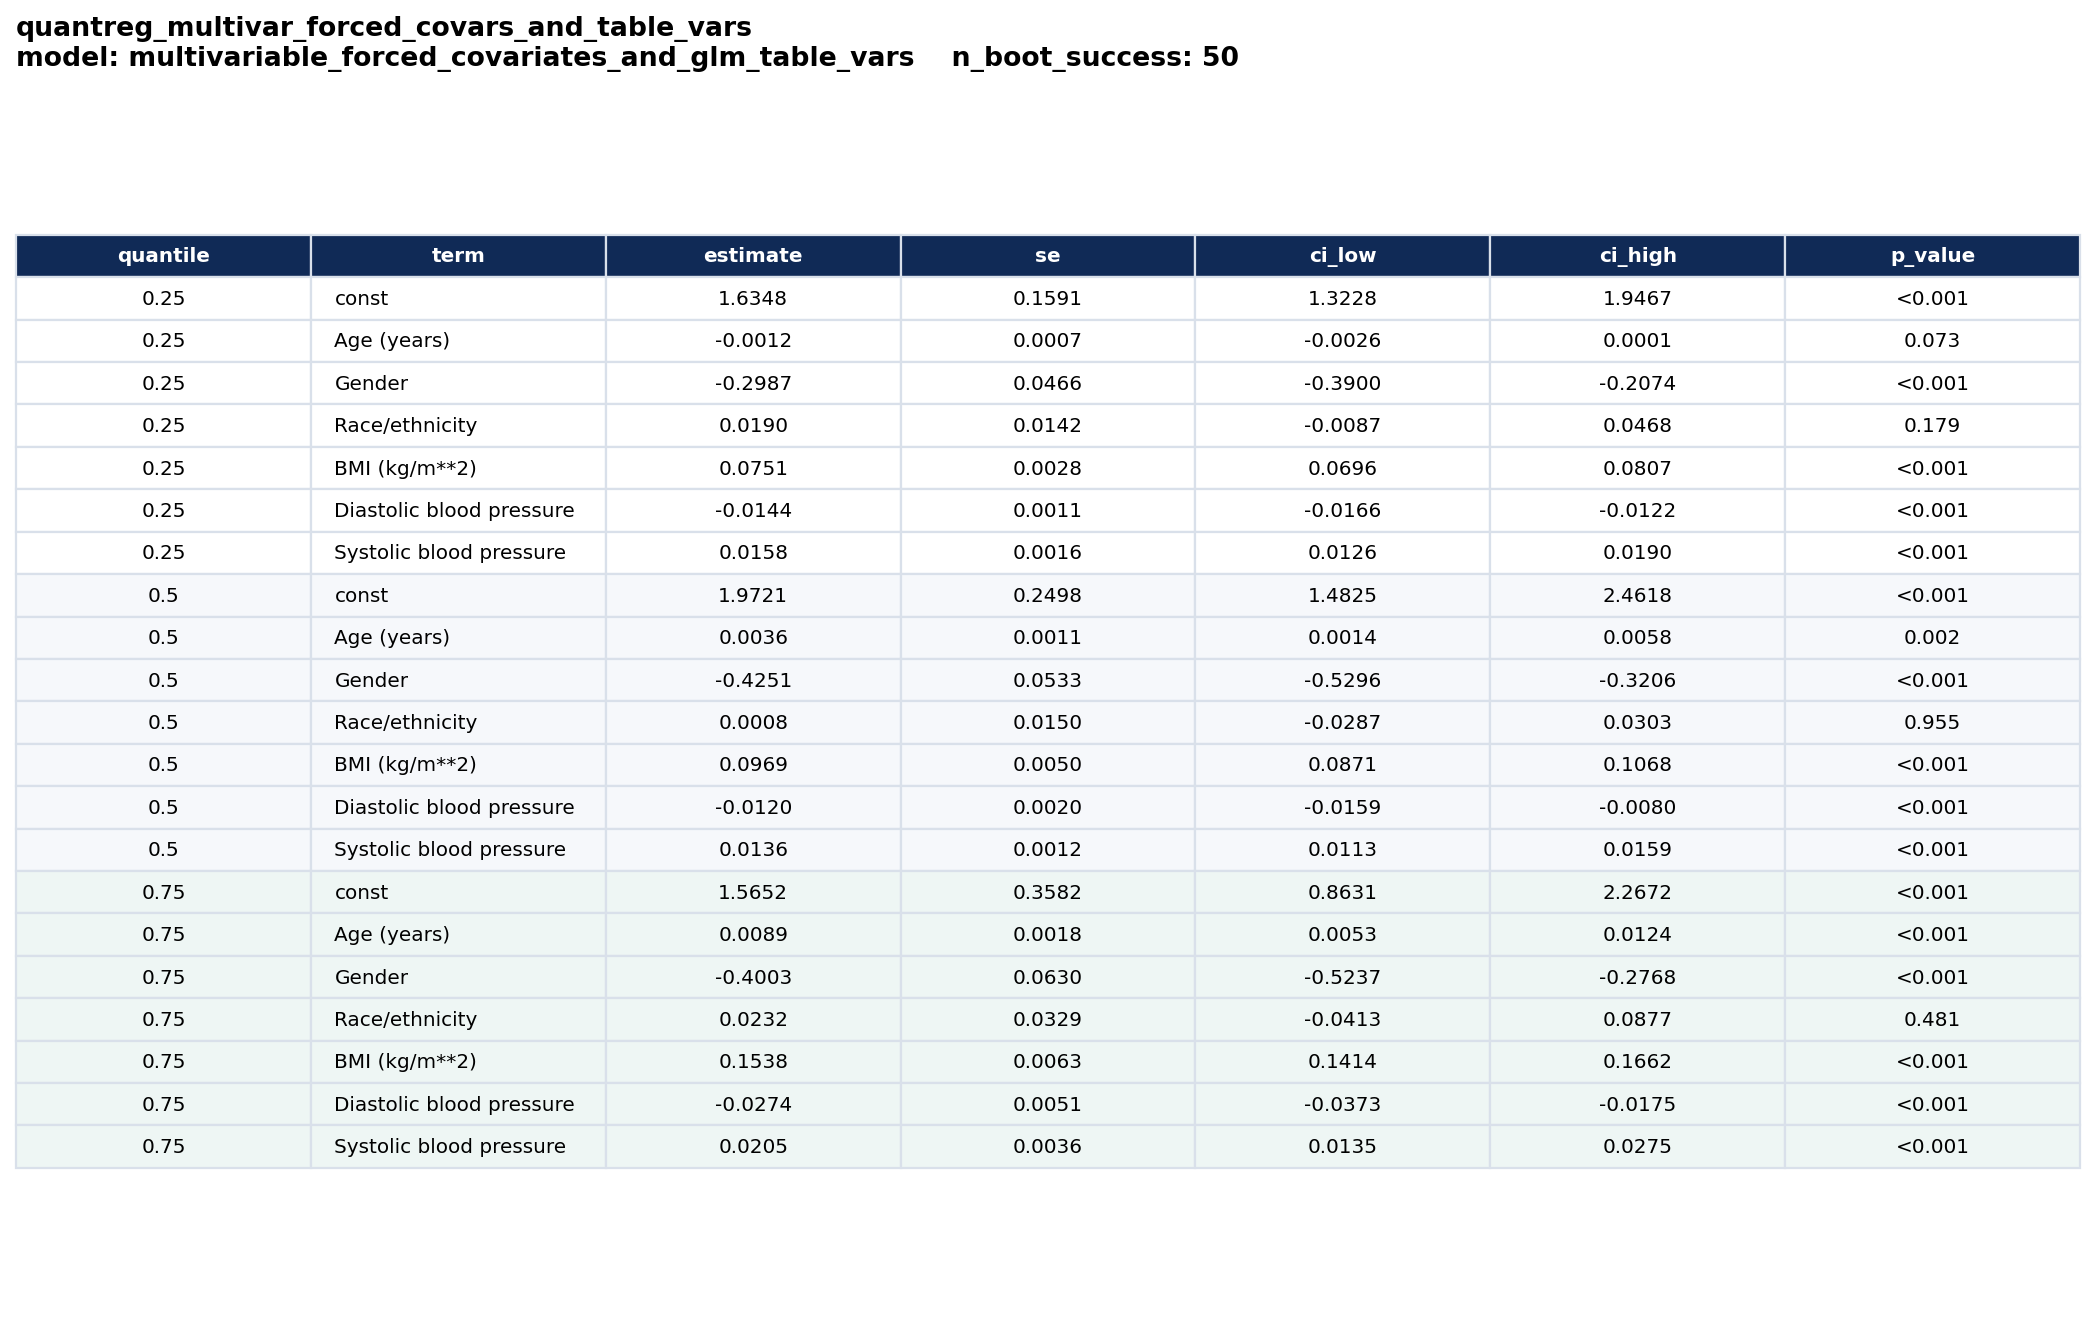
概要) 本解析では、NHANES 2021年8月~2023年8月の公開データのうち、人口学的背景、身体計測、血圧、血液生化学マーカー検査、肝臓超音波検査、血小板数の計6データを統合し、肝線維化スコアを中心とした探索的解析、欠損補完後の加重回帰、分位点回帰を実施しました。まず探索的解析では、標本重みを用いて年齢、性別、人種別の加重平均を算出し、複雑標本設計を考慮したSE、95%CI、人種差のWald検定を行いました。その結果、多くの生化学・身体計測・肝関連指標で年齢差、性差、人種差が認められ、特にBMI、creatinine、CPK、triglycerides、BUN、肝脂肪スコア、肝線維化スコアなどでは男女共通の人種差が示されました。一方、Sodiumのように集団差が小さい指標もありました。次に、欠損値に対して多重代入法(MICE)を適用し、Elastic Netで変数選択後、survey-weighted GLMとRubin統合によりLiver Fibrosis Scoreの関連因子を推定しました。その結果、BMI、AST、総ビリルビン、収縮期血圧、リンは正の関連を示し、血小板、ALT、総コレステロール、CPK、拡張期血圧、尿酸、トリグリセリドは負の関連を示しました。また女性は男性より低値、非ヒスパニック黒人は低値、非ヒスパニックアジア人は高値と関連しました。さらに分位点回帰では、BMIが最も安定して強い正の関連を示し、その影響は高分位ほど増大しました。年齢も高分位で関連が強く、女性は男性よりも一貫して低値と関連しました。高線維化群ではAST、GGT、血糖、収縮期血圧などの寄与がより強く、肝線維化の関連因子は分布全体で一様ではなく、高リスク群ほど肥満・代謝異常・肝障害指標の影響が顕著になることが示唆されました。
MICE-style multiple imputation · Elastic Net · survey-weighted Gaussian GLM · Rubin's rules · quantile regression